
一、Label标签
1. Label概述
标签(Label)是附加在Kubernetes资源(Pod、Deployment等)上的键值对,支持在资源创建时定义,也可以后期动态添加/修改。标签本身无实际业务语义,核心作用是筛选归类资源,实现批量运维管理,单个k8s资源可以配置多个不同标签。
metadata:
  labels:           # 定义标签
    app: nginx      # 标签1,键和值均可自定义
    user: mike      # 标签2,键和值均可自定义
2. 标签应用场景
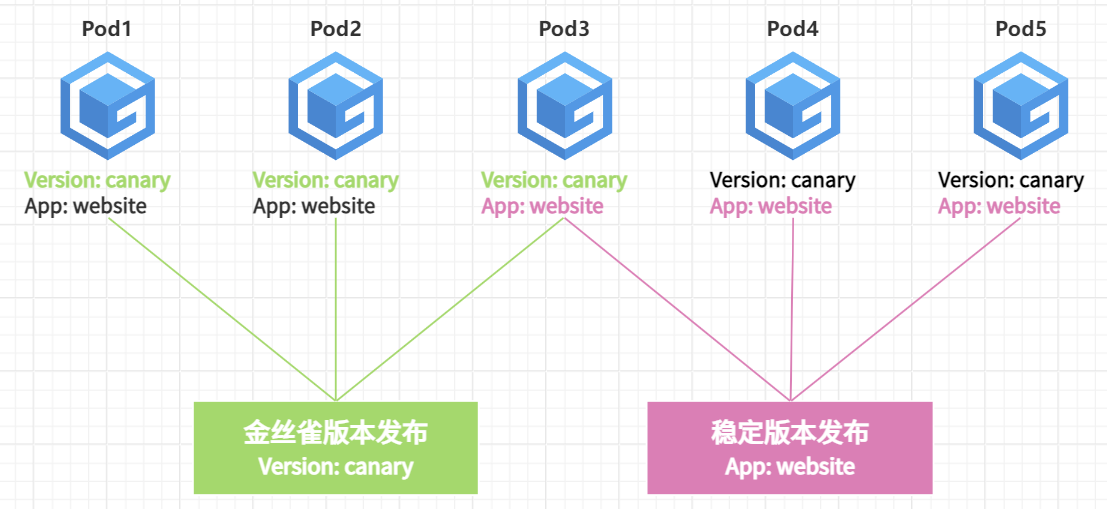
通过标签筛选,实现对不同版本、不同应用的Pod进行精确分组管理。如下图所示,通过给Pod加上两组标签,区分不同的应用场景。
labels:
  Version: canary
App: website金丝雀版本发布:选择器匹配“Version: canary”,对匹配的Pod1、Pod2、Pod3执行操作。
稳定版本发布:选择器匹配“App: website”,对匹配的Pod3、Pod4、Pod5执行操作。
3. 标签的语法
Kubernetes Label是一组附加在资源的键值对,其中的键(Key)和值(Value)需要遵循下列格式规范:
3.1 Label Key规范
唯一性:同一资源上的Label Key必须唯一
前缀规则:可选使用前缀,格式为“前缀/名称”。前缀必须为合法DNS子域,长度不超过253个字符。系统自动化组件创建的标签必须指定前缀,其中“kubernetes.io”为Kubernetes保留前缀
名称长度:长度不得超过63个字符
字符规则:必须以大小写字母或数字开头,中间可包含字母、数字、连字符(“-”)、下划线(“_”)和点(“.”)
3.2 Label Value规范
长度限制:Value的长度不得超过63个字符
字符规则:必须以大小写字母或数字开头,中间可包含字母、数字、连字符(“-”)、下划线(“_”)和点(“.”)
二、标签选择器
1. Labels Selectors概述
标签本身不具备唯一性,多个不同的Kubernetes对象可能拥有相同的标签。通过标签选择器(Labels Selectors),用户或客户端可以按标签规则筛选出一组对象,实现批量操作与资源分组管理。标签选择器是Kubernetes的核心分组与筛选机制。目前Kubernetes支持两类标签选择器:
基于等值的选择器(Equality-based):通过键值对的相等/不等关系筛选资源
基于集合的选择器(Set-based):通过集合包含、不包含等关系批量匹配标签
2. 基于等值的选择器
Equality-based标签选择器可以通过标签键和标签值完成资源筛选,支持“=”、“==”、“!=”三种运算符,其中“=”和“==”作用一致,用于判断相等关系,“!=”用于判断不等关系。
[Step1] 可以通过命令查看具有特定标签的对象。
# -l app=busybox-label只显示携带标签app=busybox-label
root@k8s-master:~# kubectl get pod -l app=busybox-label --show-labels-l:Label标签选择器
-l app=busybox-label:只显示带有标签“busybox-label”的Pod
--show-labels:显示每个Pod的标签

[Step2] 可以通过命令查看不含有该标签的对象。
root@k8s-master:~# kubectl get pod -l app!=nginx-deployment --show-labels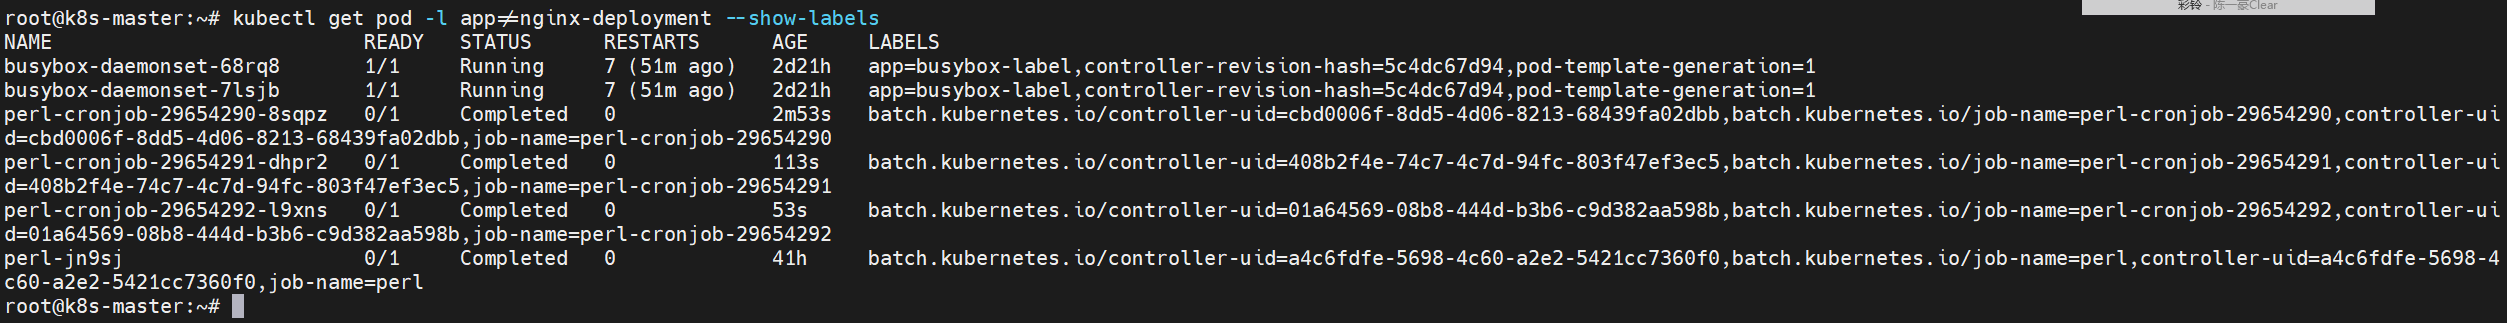
3. 基于集合的选择器
Set-based标签选择器,可依据标签值匹配一组指定标签值实现资源筛选,一共支持“in”、“notin”、“exists”三种运算符。
in:匹配标签键的值存在于指定值集合内的资源
notin:匹配标签键的值不在指定值集合内的资源
exists:仅判断标签键是否存在,不校验对应标签值
[Step1] 筛选标签键app的值为“busybox-label“或”nginx-deployment”的资源。
root@k8s-master:~# kubectl get pod -l 'app in (busybox-label,nginx-deployment)' --show-labels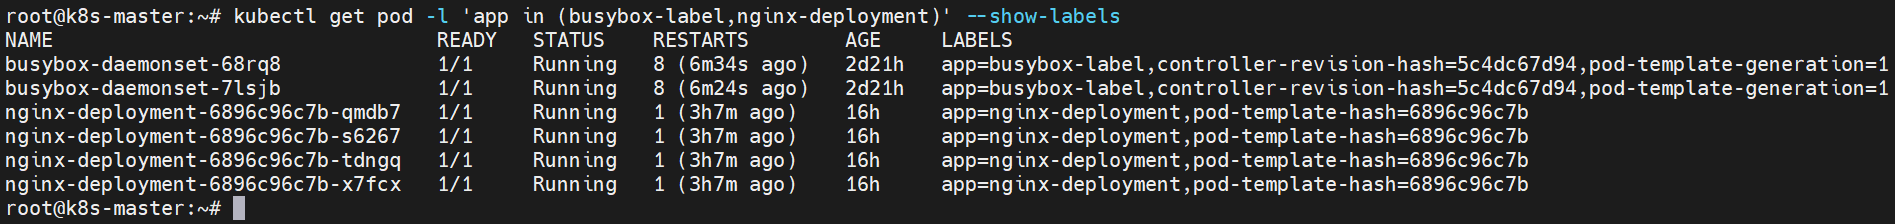
[Step2] 筛选标签键app的值不为“busybox-label“或”nginx-deployment”的资源。
root@k8s-master:~# kubectl get pod -l 'app notin (nginx-deployment,busybox-label)' --show-labels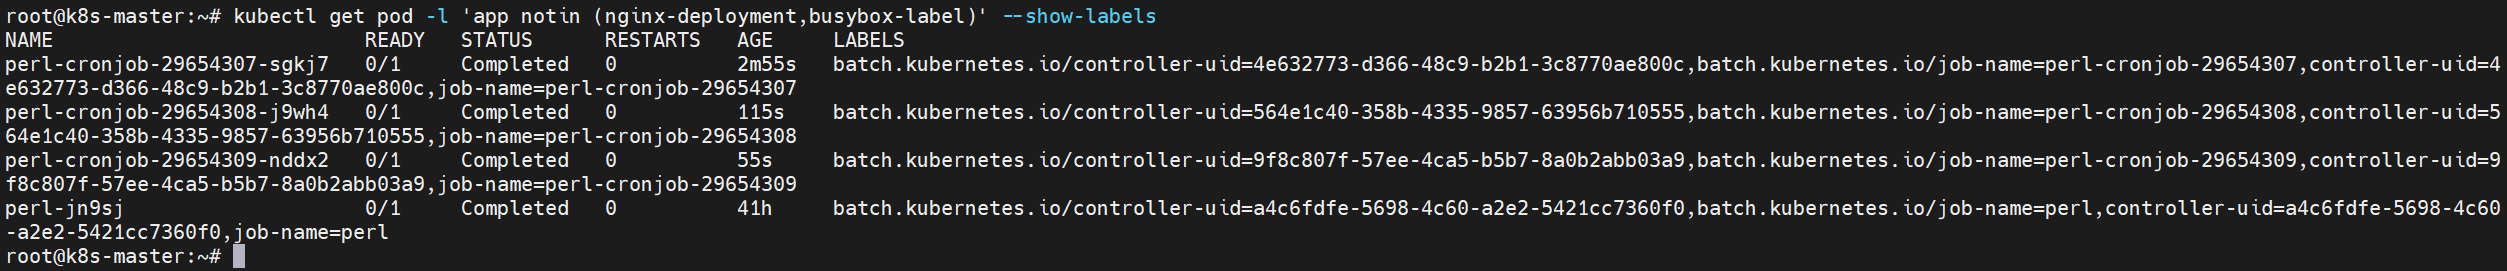
[Step3] 筛选标签键存在“app”的资源。
root@k8s-master:~# kubectl get pod -l 'app' --show-labels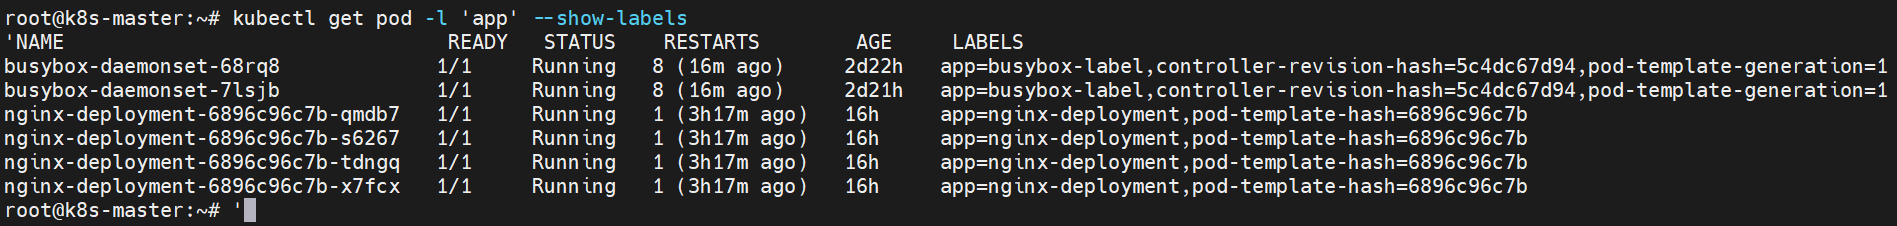
[Step4] 筛选标签键不存在“app”的资源。
root@k8s-master:~# kubectl get pod -l '!app' --show-labels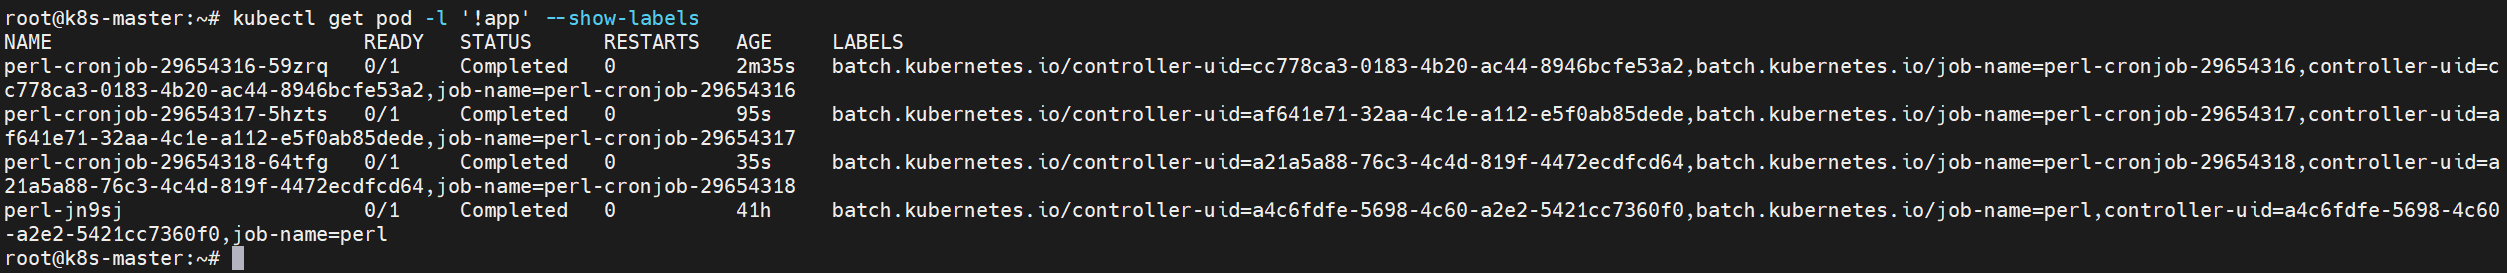
[Step5] 基于等值的标签选择器和基于集合的标签选择器也可以混用,筛选标签键app的值为“busybox-label“或”nginx-deployment”但是不包含“app=nginx-deployment”的资源。
root@k8s-master:~# kubectl get pod -l 'app in (nginx-deployment,busybox-label),app!=nginx-deployment' --show-labels
4. 标签选择器常用命令
[Step1] 查询资源对象列表时,可以通过“-L”参数直接显示标签“app”的对应值。仅携带该标签键的Pod,才会在列表中输出对应的标签值。
root@k8s-master:~# kubectl get pod -L app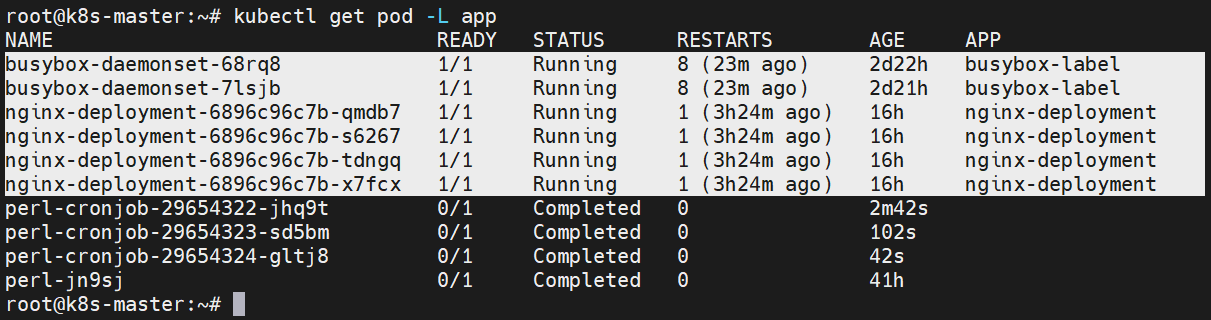
[Step2] 查询资源对象列表时,可以通过“-l”参数直接筛选指定标签的Pod。
root@k8s-master:~# kubectl get pod -l app=busybox-label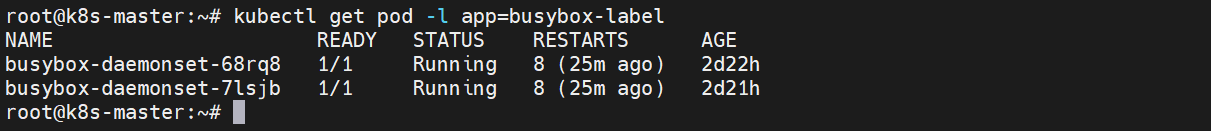
[Step3] 给节点加上自定义标签。然后查看当前集群的所有节点,通过“-L”参数显示标签“machine”的对应值。
root@k8s-master:~# kubectl label nodes k8s-worker1 machine=test
root@k8s-master:~# kubectl get nodes -L machine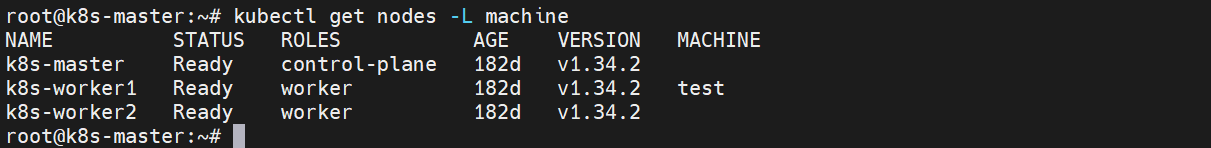
[Step4] 查看当前集群的所有节点,通过“--show-labels”参数显示所有标签。
root@k8s-master:~# kubectl get nodes --show-labels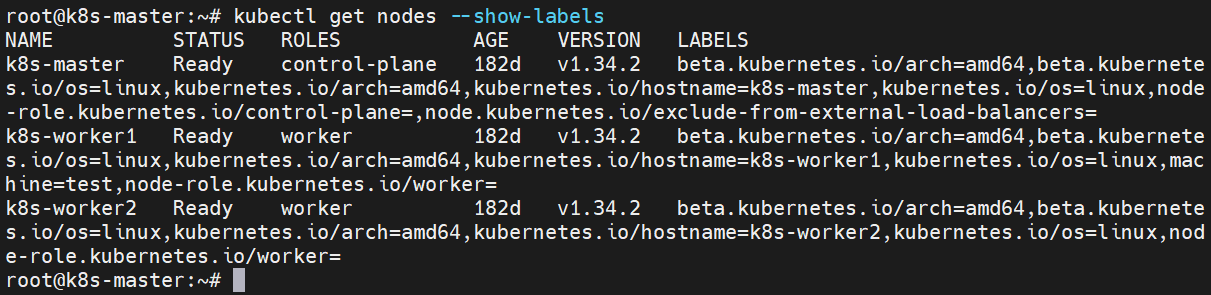
三、nodeSelector基础案例
1. 通过nodeSelector选择运行节点
[Step1] 给k8s-worker1节点加上Label。
root@k8s-master:~# kubectl label nodes k8s-worker1 machine=static[Step2] 验证:查询资源列表,显示携带标签“machine”的节点。
root@k8s-master:~# kubectl get node -L machine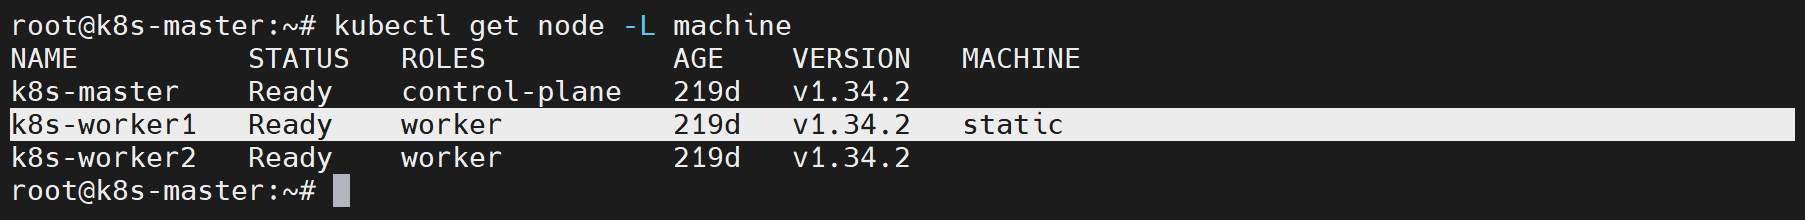
[Step3] 本地新建YAML清单,定义Deployment资源描述模板。
root@k8s-master:~# vim busybox-k8s-worker1.yml
# 写入下列内容
apiVersion: apps/v1 # 固定语法
kind: Deployment # 资源类型
metadata:
name: busybox-worker1
labels: # 定义标签
app: busybox # 自定义标签(键和值均可自定义)
spec:
replicas: 3
selector:
matchLabels: # 标签匹配模式:精确匹配
app: busybox # 匹配的标签值
template:
metadata:
labels: # 给Pod加上标签,需要和selector定义一致
app: busybox
spec:
containers:
- name: busybox
image: busybox:latest
imagePullPolicy: IfNotPresent
command: ["sleep","3600"]
nodeSelector: # 定义节点选择器
machine: static # 节点必须携带的标签[Step2] 基于YAML清单向Kubernetes集群声明式地创建Deployment资源。
root@k8s-master:~# kubectl create -f busybox-k8s-worker1.yml[Step3] 验证:查看当前集群中的所有Deployment资源。
root@k8s-master:~# kubectl get deployments.apps/busybox-worker1
[Step4] 验证:查看当前命名空间下所有的Pod,能够看到3个以httpd-worker1名称开头的Pod,同时这些Pod都运行在k8s-worker1上。
root@k8s-master:~# kubectl get pod -o wide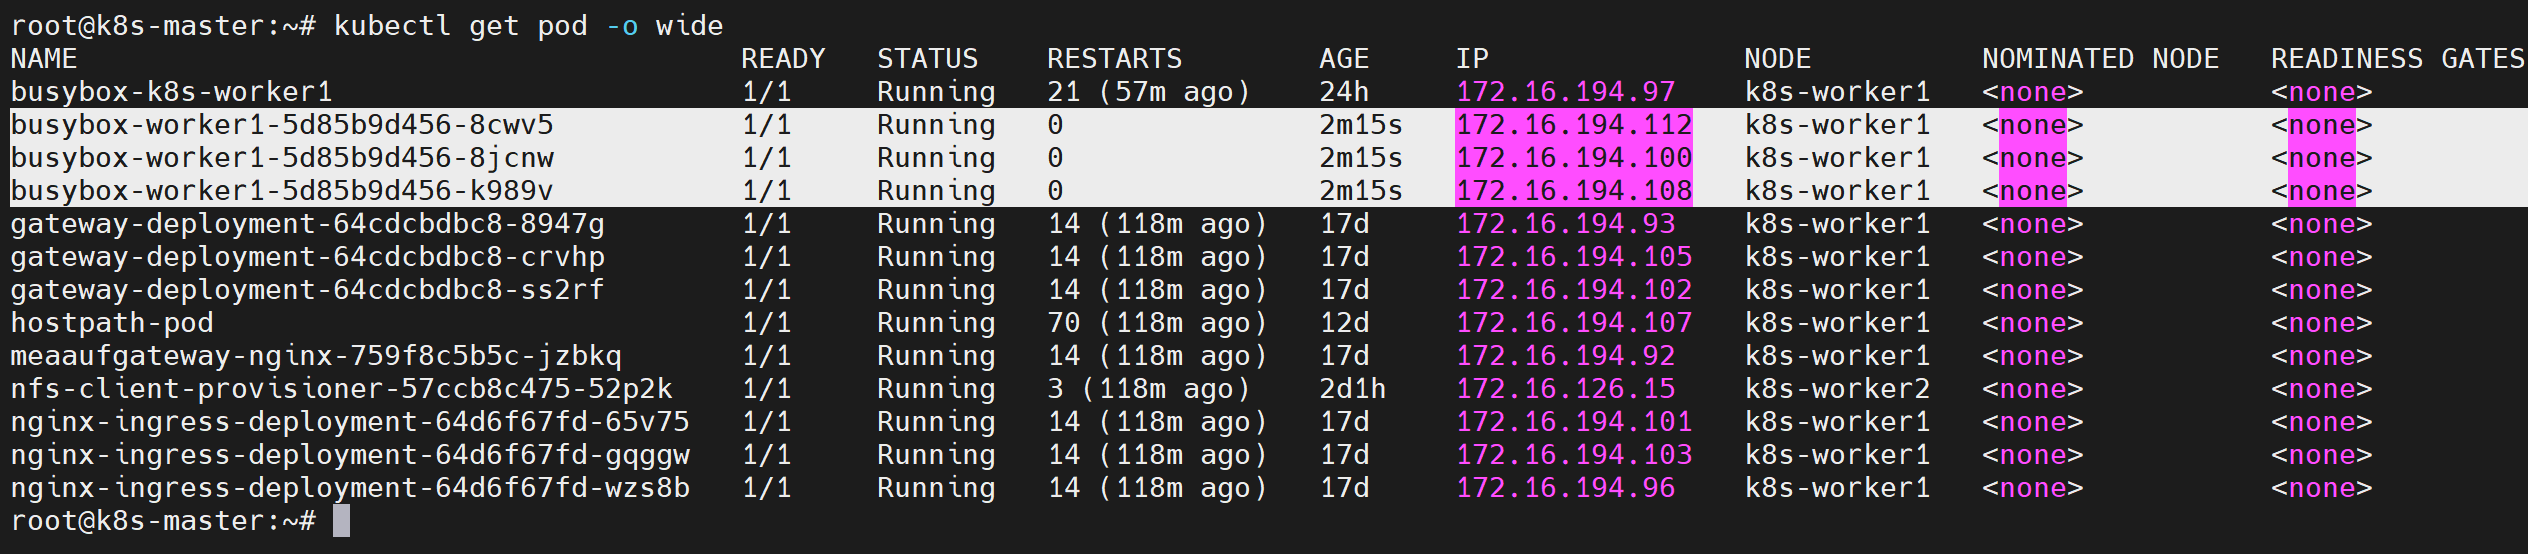
2. 通过nodeName选择运行节点
nodeName相比nodeSelector调度逻辑更直接,可直接硬性指定Pod调度至目标节点。
[Step1] 本地新建YAML清单,定义Pod资源描述模板。
root@k8s-master:~# vim busybox-k8s-worker2.yml
# 写入下列内容
apiVersion: v1
kind: Pod
metadata:
name: busybox-worker2
spec:
containers:
- name: busybox
image: busybox:latest
imagePullPolicy: IfNotPresent
command: ["sleep","3600"]
nodeName: k8s-worker2 # 指定调度到k8s-worker2[Step2] 基于YAML清单向Kubernetes集群声明式地创建Pod资源。
root@k8s-master:~# kubectl create -f busybox-k8s-worker2.yml[Step3] 验证:查看当前命名空间下所有的Pod,可以看到创建的Pod运行在k8s-worker2上。
root@k8s-master:~# kubectl get pods -o wide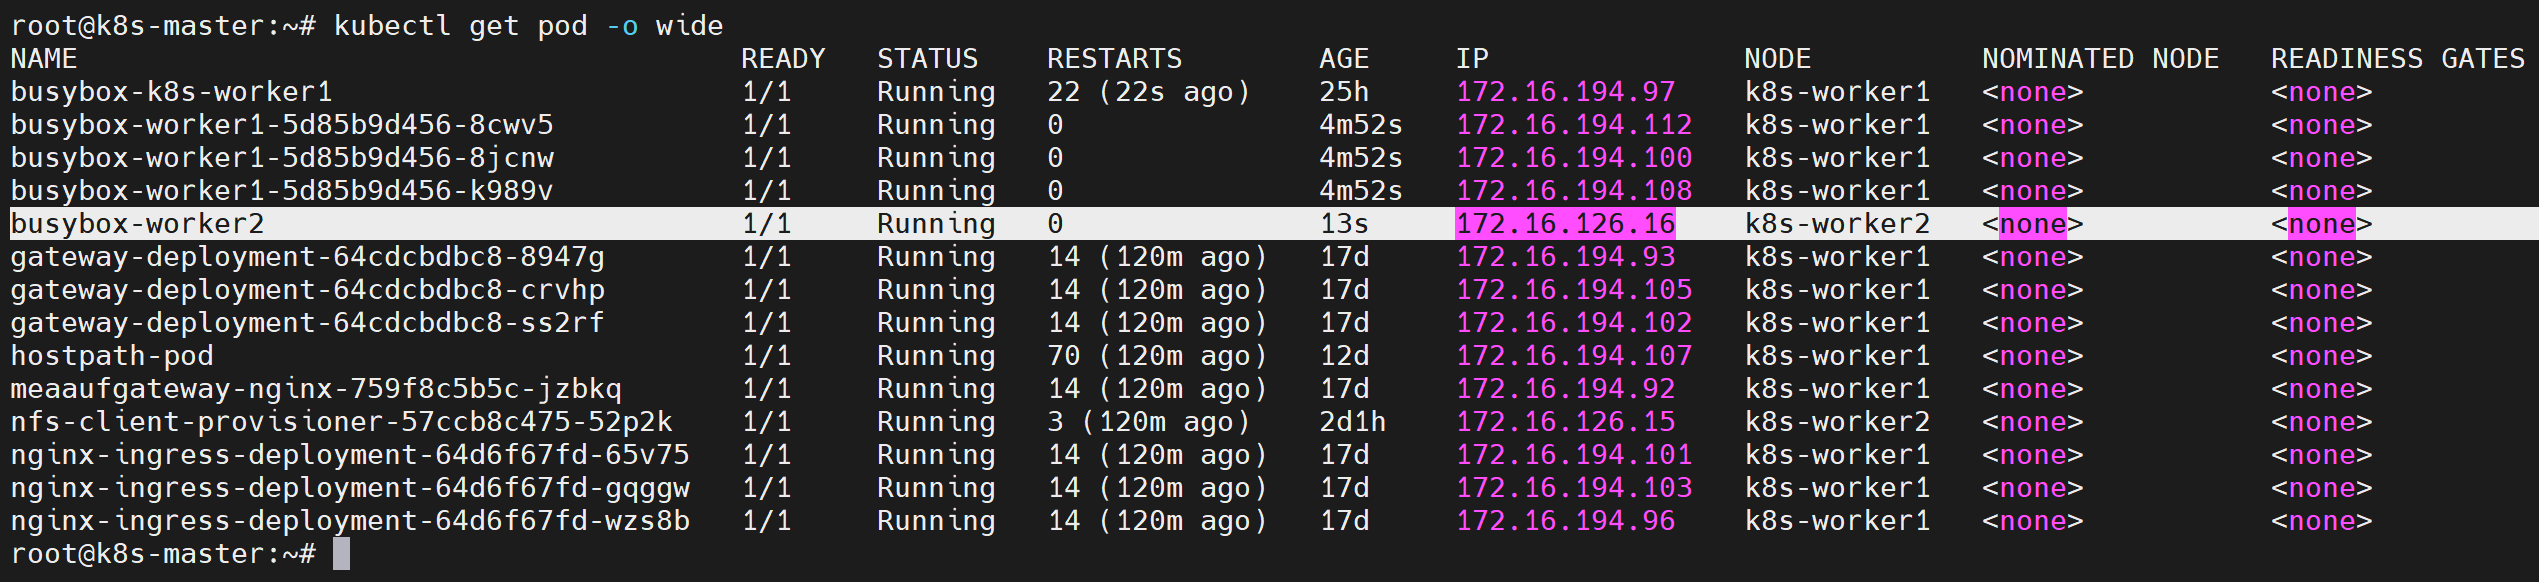
四、节点亲和性
1. 节点亲和性定义
节点亲和性(Node Affinity)用于设置Pod调度倾向,使其优先或强制调度至指定节点,相较于“nodeSelector”功能更强、配置更灵活的节点调度策略。Node Affinity区分软硬调度策略,支持多条件组合、逻辑判断与多种标签匹配表达式。节点亲和性一共分为两类:
requiredDuringSchedulingIgnoredDuringExecution:硬亲和性策略,属于强制调度策略,节点不满足条件则Pod无法完成调度,状态持续为“Pending”。
preferredDuringSchedulingIgnoredDuringExecution:软亲和性策略,属于优选调度规则,优先匹配符合条件的节点。如果没有合适节点,Pod仍可以调度至其他节点正常运行。
新版节点亲和性语法提供In、NotIn、Exists、DoesNotExist、Gt、Lt六种操作符。可以通过NotIn、DoesNotExist实现节点排斥调度,也可借助节点污点实现Pod驱逐。
2. Node Affinity指定运行节点
[Step1] 给k8s-worker2节点加上自定义标签。然后查看当前集群的所有节点,通过“-L”参数显示标签“machine”的对应值。
root@k8s-master:~# kubectl label nodes k8s-worker2 machine=dynamic
root@k8s-master:~# kubectl get nodes -L machine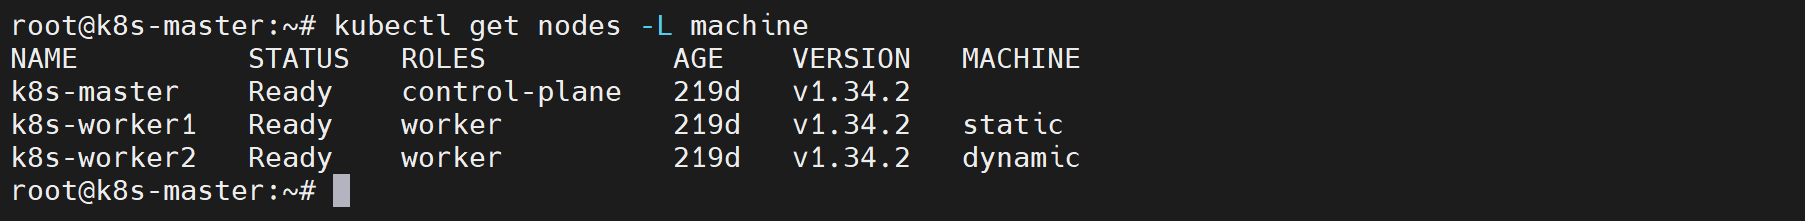
[Step2] 本地新建YAML清单,定义Deployment资源描述模板。
root@k8s-master:~# vim httpd-k8s-worker2.yml
# 写入下列内容
apiVersion: apps/v1 # 固定语法
kind: Deployment # 资源类型
metadata:
name: httpd-worker2
labels: # 定义标签
app: httpd # 自定义标签(键和值均可自定义)
spec:
replicas: 3
selector:
matchLabels: # 标签匹配模式:精确匹配
app: httpd # 匹配的标签值
template:
metadata:
labels: # 给Pod加上标签,需要和selector定义一致
app: httpd
spec:
containers:
- name: httpd
image: httpd:latest
imagePullPolicy: IfNotPresent
ports:
- containerPort: 80
affinity: # 节点亲和性配置
nodeAffinity: # 针对节点的调度规则
# 硬亲和性
requiredDuringSchedulingIgnoredDuringExecution:
nodeSelectorTerms:
- matchExpressions:
- key: machine # 节点标签的key是machine
operator: In # 操作符,属于/在列表内
values: # 标签值列表
- dynamic # 标签值为demo[Step3] 基于YAML清单向Kubernetes集群声明式地创建Deployment资源。
root@k8s-master:~# kubectl create -f httpd-k8s-worker2.yml[Step4] 验证:查看当前集群中的所有Deployment资源。
root@k8s-master:~# kubectl get deployments.apps/httpd-worker2
[Step5] 验证:查看当前命名空间下所有的Pod,能够看到3个以httpd-worker2名称开头的Pod,同时这些Pod都运行在k8s-worker2上。
root@k8s-master:~# kubectl get pod -o wide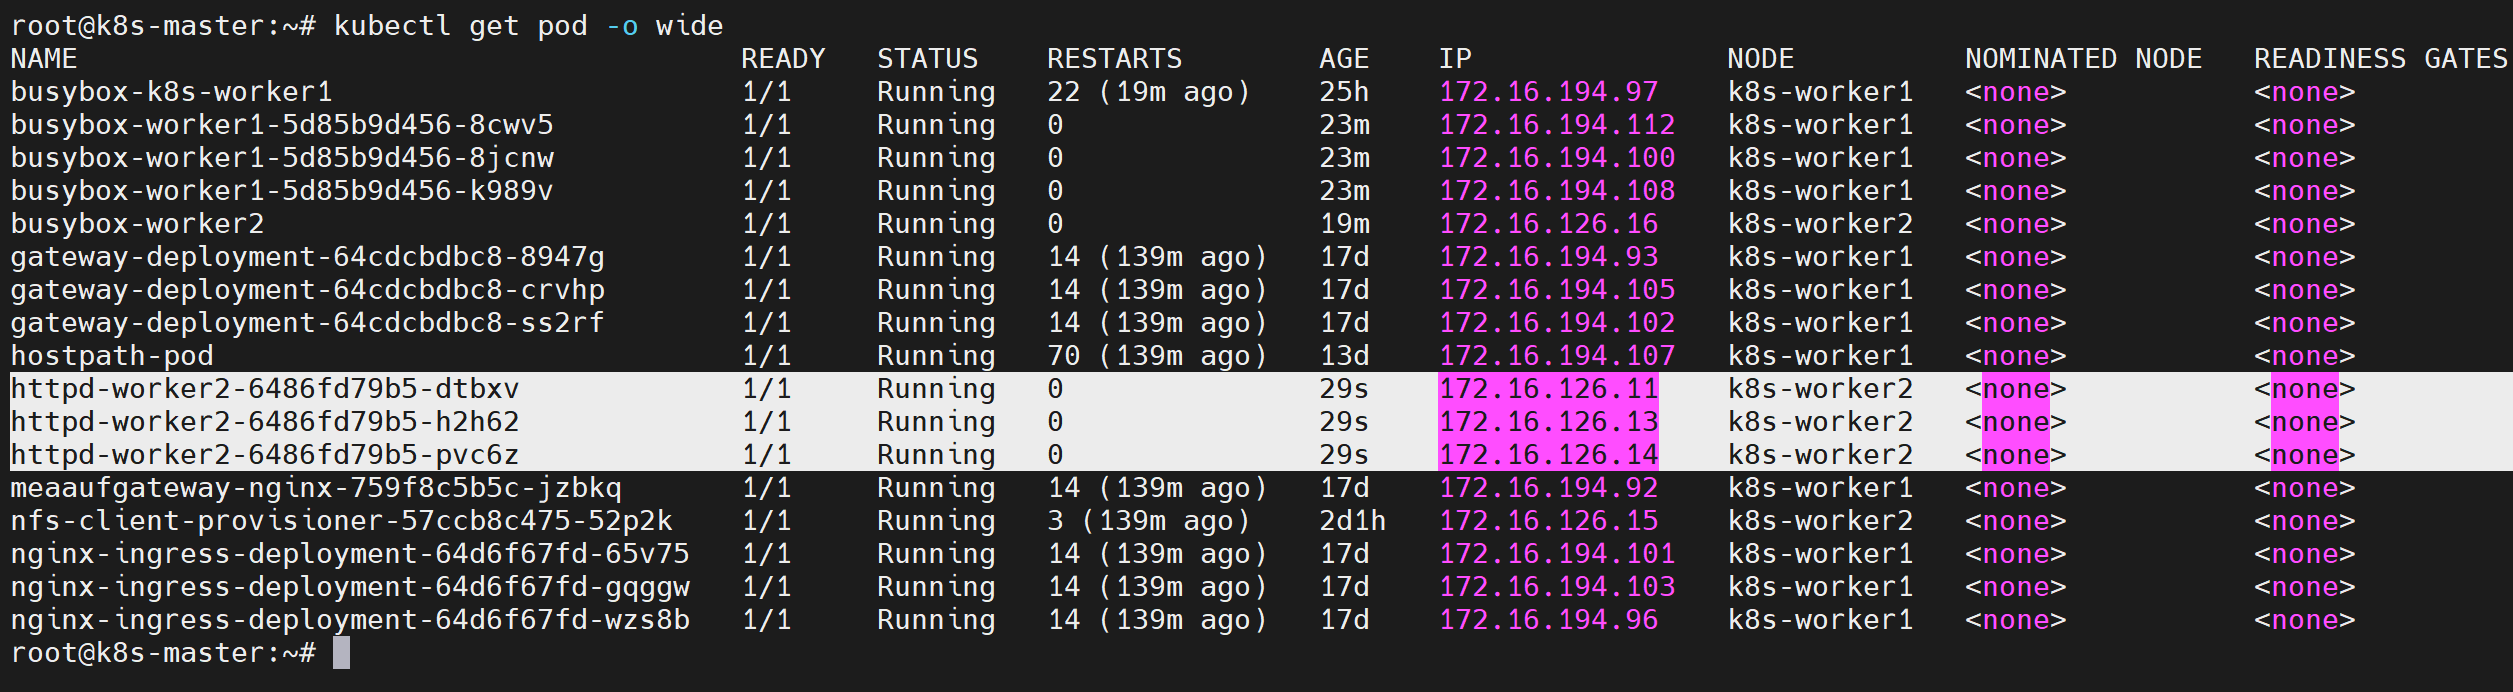
五、污点与容忍度
将集群节点类比为公司的工位,Pod类比为员工: 1.节点亲和性:员工自主选择工位,对应Pod主动调度到至指定类型节点。 2.节点污点:工位张贴限制标识,对应节点主动拒绝不符合条件的Pod调度。 3.容忍度:员工持有通行许可,对应Pod可以忽略节点污点的排斥限制,正常调度至该节点。
2. 污点和容忍度定义
节点亲和性是Pod调度属性,作用是将Pod调度至匹配标签的指定节点;污点(Taint)逻辑与之相反,用于让节点拒绝调度特定Pod。
容忍度(Toleration)配置在Pod侧,作用是允许Pod调度至存在匹配污点的节点,但不会强制调度。污点和容忍度搭配使用,可以规避Pod调度至不适配节点。单个节点可以配置多条污点,无法容忍对应污点的Pod将无法调度至该节点。节点添加污点后,无匹配容忍度的Pod会被直接拒绝调度。
3. 容忍度运算符(operator)
容忍度运算符(operator)默认值为Equal。容忍度与污点匹配需要满足键名和效果一致,同时遵循以下规则:
运算符为“Exists”时,容忍度不可配置“value”;
运算符为“Equal”时,容忍度与污点的“value”值必须相同。
如果容忍度的键为空且运算符为“Exists”,该容忍度可以匹配任意键、值和效果的污点。也就是可以容忍集群中所有的污点。如果容忍度未配置“effect”,则可以匹配任意键对应的所有污点效果。
4. 调度动作(effect)
污点与容忍度中的effect用于定义节点对无法匹配该污点Pod执行何种调度处置动作,是污点约束行为的识别字段。污点完整的三元组书写格式如下所示,其中effect共有三种取值,分别为:“NoSchedule、PreferNoSchedule、NoExecute”。
key=value:effect // effect定义排斥逻辑NoSchedule:新的Pod不会调度到该节点,已运行在节点上的旧Pod不会受到影响,不会被驱逐。仅拦截调度阶段,不会干涉存量业务。
PreferNoSchedule:尽量避免调度,软限制。调度器会优先不把Pod分配到此节点,若无其他可用节点,Pod依然可以调度过来。
NoExecute:双重限制,硬限制。新的Pod禁止调度到此节点,已经运行在节点上,无法容忍该污点的Pod,会直接被驱逐删除。可以配置“tolerationSeconds”延迟一段时后再驱逐Pod。
六、调度优先级和抢占机制
1. 调度优先级和抢占机制概述
当Pod调度失败时会进入Pending状态,只有在Pod配置更新或集群资源状态发生变动后,调度器才会再次尝试调度该Pod。对于高优先级的Pod,调度失败后不会单纯停留在Pending状态,它可以直接触发抢占机制,驱逐节点上部分低优先级Pod,释放资源以保障自身调度成功。
Pod优先级(Priority)和抢占(Preemption)机制,用于处理初次调度失败后的后续处理逻辑,并不会在Pod初始调度过程中直接触发。
2. Priorityclass
Kubernetes规定,优先级为32位整数,上限10亿,数值越大代表优先级越高。大于10亿的优先级数值由Kubernetes预留,仅分配给系统Pod,以此保障系统核心Pod不会被用户业务Pod抢占资源。
PriorityClass属于集群级全局资源,不受命名空间约束,可理解为优先级模板。管理员能够依据业务重要程度设置不同优先级权重,Pod通过引用对应的PriorityClass获得调度优先级,以此规定资源紧张场景下业务的运行次序与抢占规则。
可以把集群节点比作停车场,Pod视作车辆,PriorityClass就相当于车辆的优先级标识。当车位全部占满时,调度器能够驱离低优先级车辆,为高优先级车辆腾出车位。
默认情况下,未配置“priorityClassName”的Pod优先级数值为0,所有Pod优先级相同;资源不足时,系统随机选择Pod进行驱逐。PriorityClass具备两大核心作用:
调度队列优先:在调度队列中,高优先级Pod优先处理、优先分配节点资源,低优先级Pod排队等待。
资源抢占(Preemption):集群资源耗尽、高优先级Pod无法正常调度时,调度器会驱逐节点上正在运行的低优先级Pod,释放CPU与内存资源,保障高优先级Pod正常调度。
[Step1] 查看当前集群中内置的优先级类,由集群内初始化时自动创建,禁止业务使用。
root@k8s-master:~# kubectl get priorityclasses.scheduling.k8s.ioNAME:优先级类名称,内置资源,无法删除、修改。
VALUE:数值大于10亿,属于系统专属优先级,数字越大则优先级越高。
GLOBAL-DEFAULT:设置为集群默认,false表示没有设置为集群默认。
AGE:222d:资源已存在222天。
PREEMPTIONPOLICY:PreemptLowerPriority:资源不足时,可以驱逐优先级更低的Pod以保障自身运行。

[Step2] 查看内置优先级类“system-cluster-critical”,可以看到优先级数值为2000000000(系统高优先级),该优先级数值不作为集群默认优先级。抢占策略为抢占更低优先级Pod。主要供给集群关键系统Pod使用,保障核心组件运行,必要时可迁移至其他节点。
root@k8s-master:~# kubectl describe priorityclasses system-cluster-critical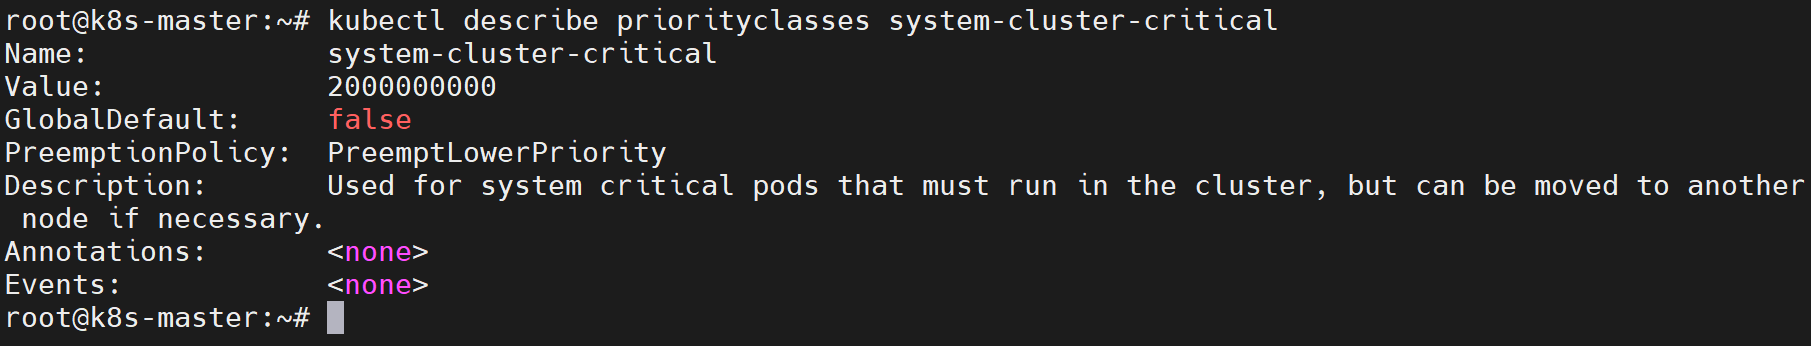
[Step3] 查看内置优先级类“system-node-critical”,可以看到优先级数值为2000000000(系统高优先级),该优先级数值不作为集群默认优先级。支持抢占低优先级Pod,专供节点核心系统Pod使用,此类Pod不能迁移到其他节点。
root@k8s-master:~# kubectl describe priorityclasses system-node-critical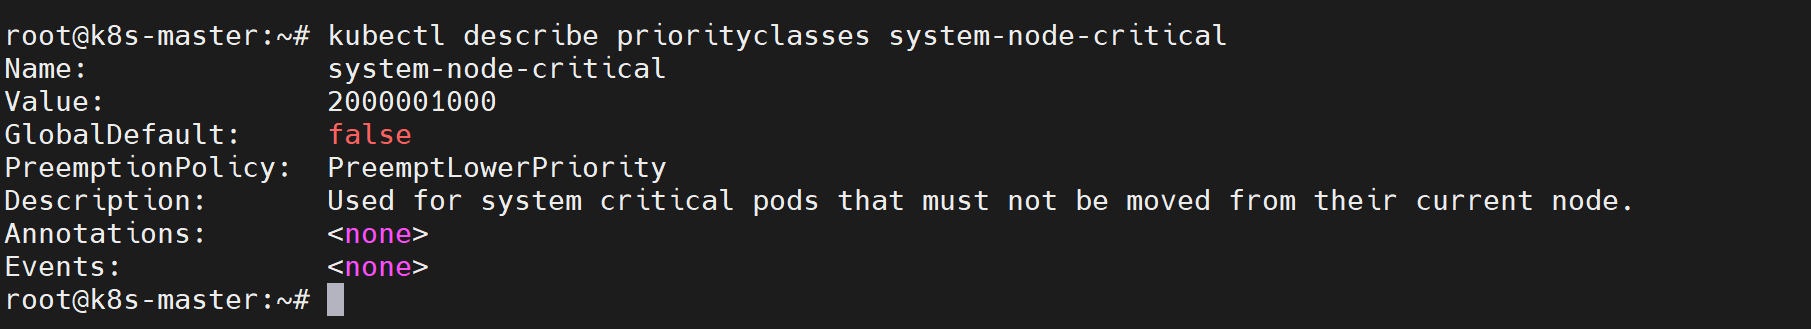
3. Priorityclass资源定义
在Kubernetes中,优先级与抢占机制自1.10版本起逐步提供支持。若要启用该机制,首先需要在集群中创建定义PriorityClass资源。PriorityClass还存在两个可选字段:globalDefault、description。
globalDefault:设置集群全局默认优先级,有且只允许存在一个。当globalDefault值为true时,所有创建时未指定priorityClassName的Pod,会自动引用该优先级数值。
description:文本备注字段,无调度逻辑,仅用于注释说明。
[Step1] 最基础的PriorityClass资源定义YAML清单文件。
apiVersion: scheduling.k8s.io/v1    # 固定语法
kind: PriorityClass     # 资源类型
metadata:
  name: high-priority
# 优先级数值,业务建议0~1000000000,此处50000为中等优先级
value: 50000
globalDefault: true     # 是否作为集群全局默认优先级
4. globalDefault
globalDefault是PriorityClass的布尔类型配置参数,用于定义当前优先级类别是否为集群默认优先级,具体规则如下表所示。
七、污点与容忍度基础案例
1. NoSchedule调度
[Step1] 给k8s-worker1节点加上污点,污点调度动作为“NoSchedule”。
root@k8s-master:~# kubectl taint nodes k8s-worker1 maintain=true:NoExecute[Step2] 验证:查看k8s-worker1上的污点是否添加成功。
root@k8s-master:~# kubectl describe nodes k8s-worker1 | grep Taints
[Step3] 本地新建YAML清单,定义Pod资源描述模板。
root@k8s-master:~# vim nodeschedule-pod.yml

# 写入下列内容
apiVersion: v1		# 固定语法
kind: Pod			# 资源类型
metadata:
  name: nodeschedule-pod
spec:
  tolerations:		# 容忍度配置
    - key: "maintain"		# 匹配的污点键名
      operator: "Equal"		# 容忍度运算符,要求污点value和下面value一致
      value: "true"			# 匹配的污点值
      effect: "NoSchedule"	# 调度动作
  containers:
    - name: busybox
      image: busybox:latest
      imagePullPolicy: IfNotPresent
      command: ["sleep","3600"]
[Step4] 基于YAML清单向Kubernetes集群声明式地创建Pod资源。
root@k8s-master:~# kubectl create -f nodeschedule-pod.yml[Step5] 验证:查看当前命名空间下所有的Pod,可以看到Pod被调度到k8s-worker2上。原因在于NoSchedule污点会阻止新的Pod调度至k8s-worker1,因此Pod被调度到k8s-worker2。
root@k8s-master:~# kubectl get pod -o wide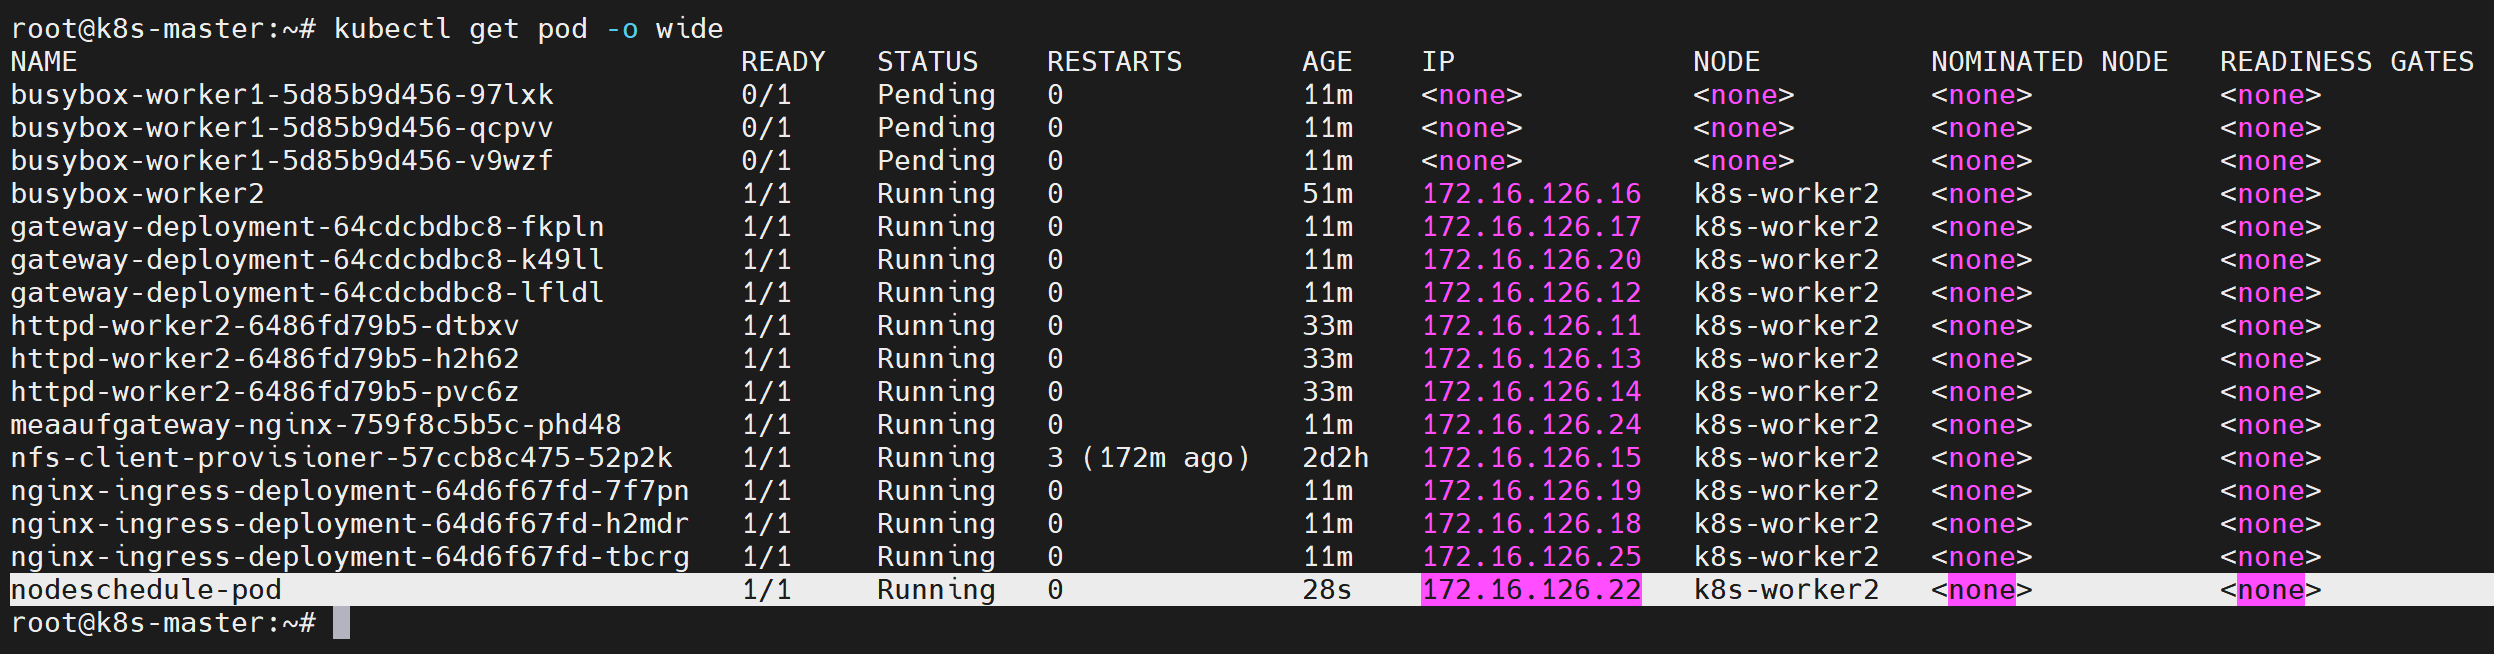
2. NoExecute调度
[Step1] 添加污点前,先查看已调度至k8s-worker2上的Pod状态,可以看到均为“Running”。
root@k8s-master:~# kubectl get pods -o wide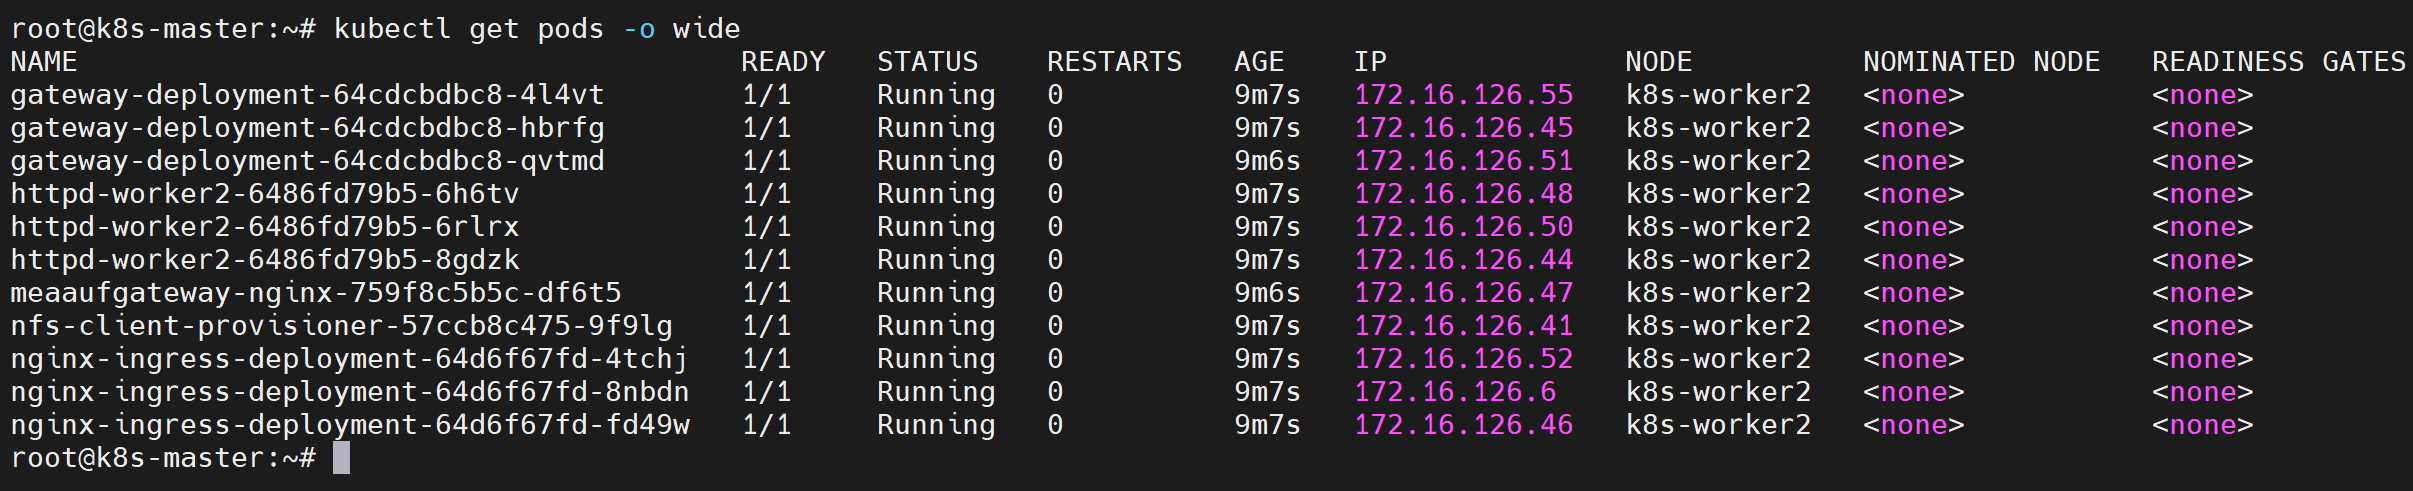
[Step2] 给k8s-worker2节点加上污点,污点调度动作为“NoExecute”,然后查看k8s-worker2上的污点。
root@k8s-master:~# kubectl taint node k8s-worker2 maintain=false:NoExecute
root@k8s-master:~# kubectl describe nodes k8s-worker2 | grep Taints
[Step3] 验证:重新查看已调度至k8s-worker2上的Pod状态,可以看到因为无法容忍污点,状态全部变更为“Pending”。
root@k8s-master:~# kubectl get pods -o wide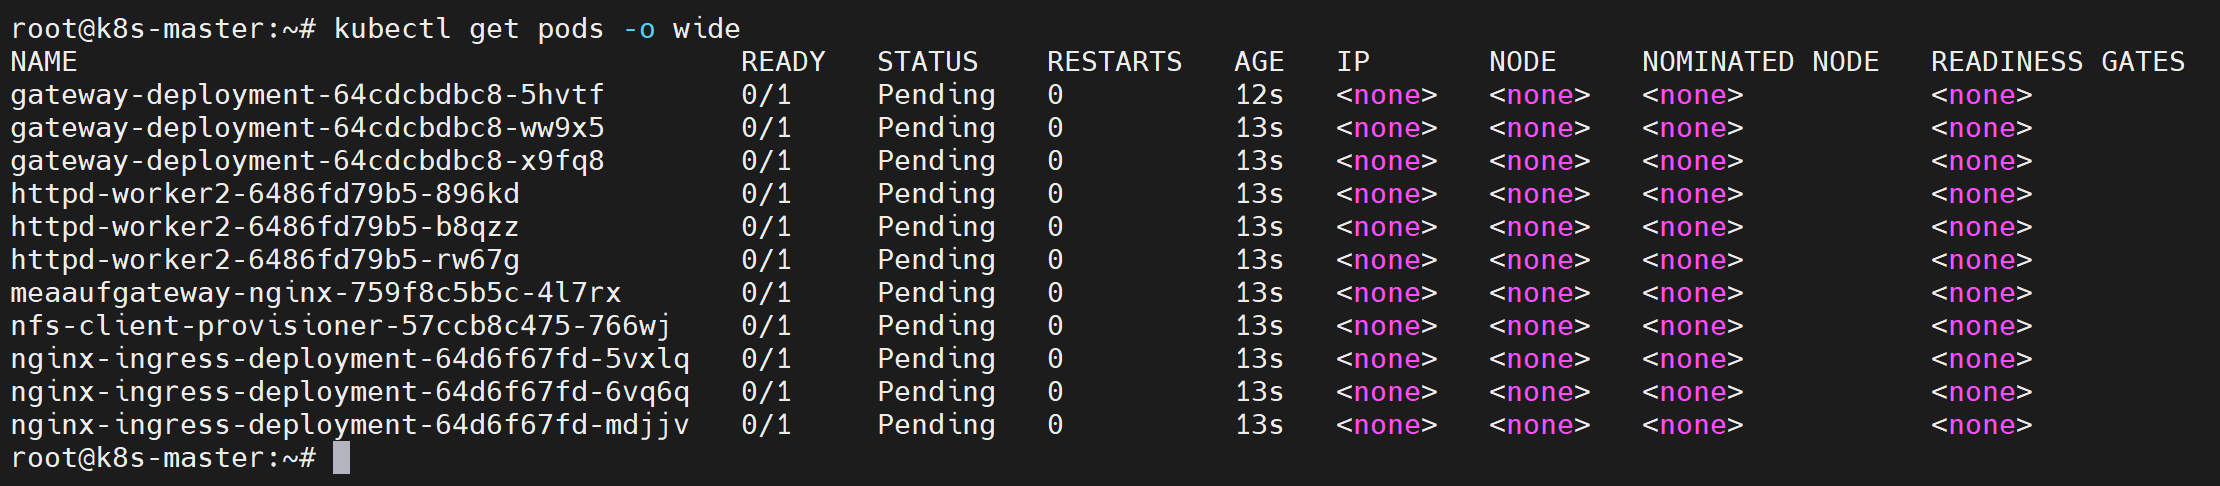
[Step4] 给k8s-worker2节点删除污点,查看当前命名空间下所有Pod状态,可以看到状态恢复为“Running”。
root@k8s-master:~# kubectl taint node k8s-worker2 maintain-
root@k8s-master:~# kubectl get pods -o wide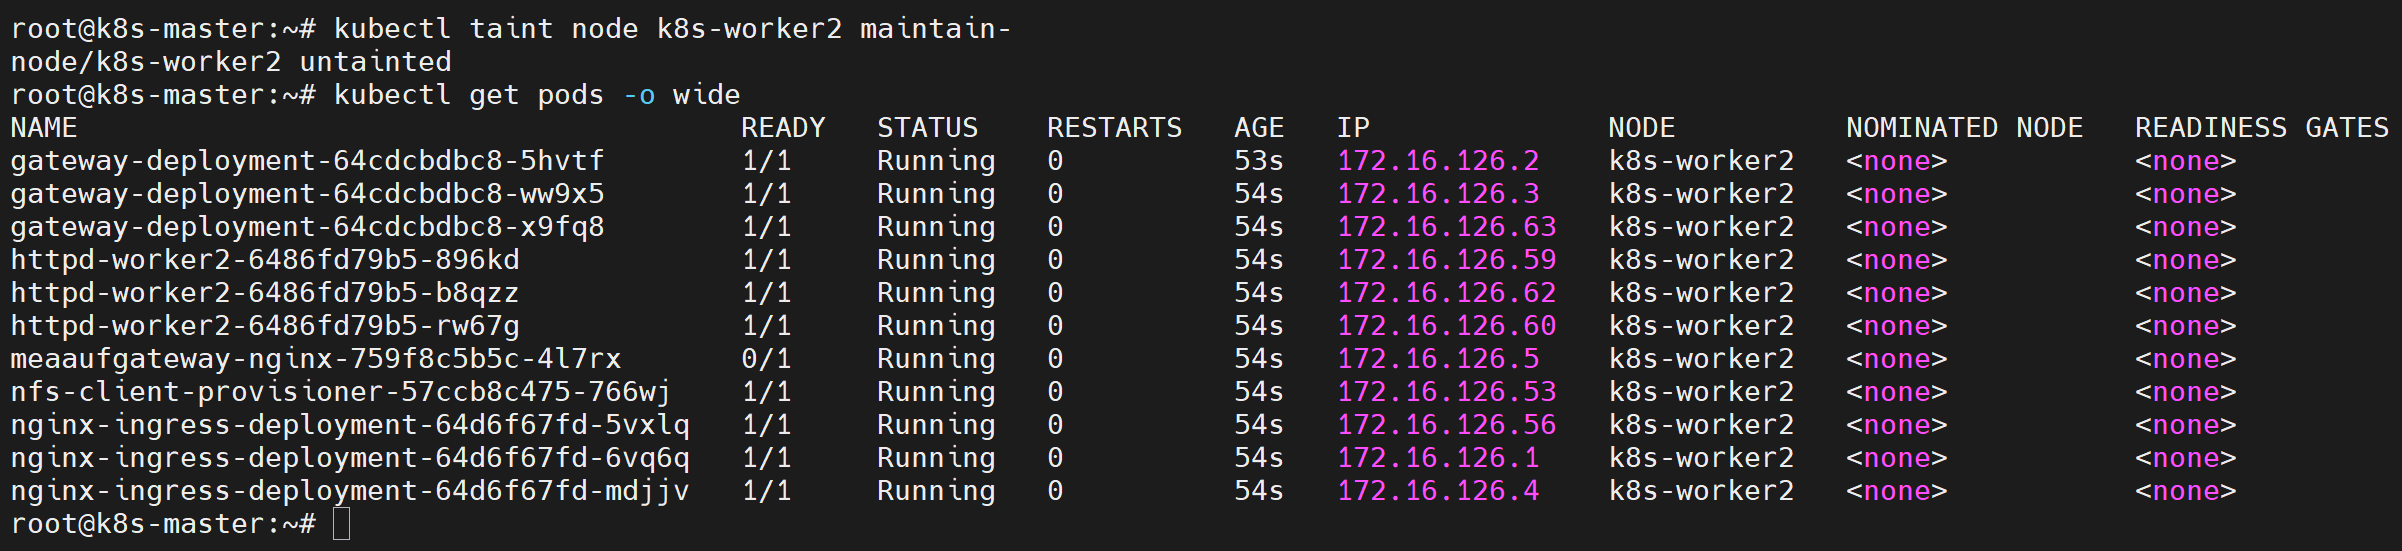
3. 无视任何污点
无论节点有什么key、value、effect的污点,Pod都能够正常调度 。
[Step1] 本地新建YAML清单,定义Pod资源描述模板。
root@k8s-master:~# vim powerful-pod.yml
# 写入下列内容
apiVersion: v1 # 固定语法
kind: Pod # 资源类型
metadata:
name: powerful-pod
spec:
tolerations: # 容忍度配置
- key: "" # 匹配的污点键名,留空
# 容忍度运算符,容忍度不可配置value
operator: "Exists"
# 不写value和effect
containers:
- name: busybox
image: busybox:latest
imagePullPolicy: IfNotPresent
command: ["sleep","10000"]
nodeName: k8s-worker1[Step2] 基于YAML清单向Kubernetes集群声明式地创建Pod资源。
root@k8s-master:~# kubectl create -f powerful-pod.yml[Step3] 验证:查看当前命名空间下所有的Pod,可以看到Pod已无视污点被调度到k8s-worker1上。
root@k8s-master:~# kubectl get pod -o wide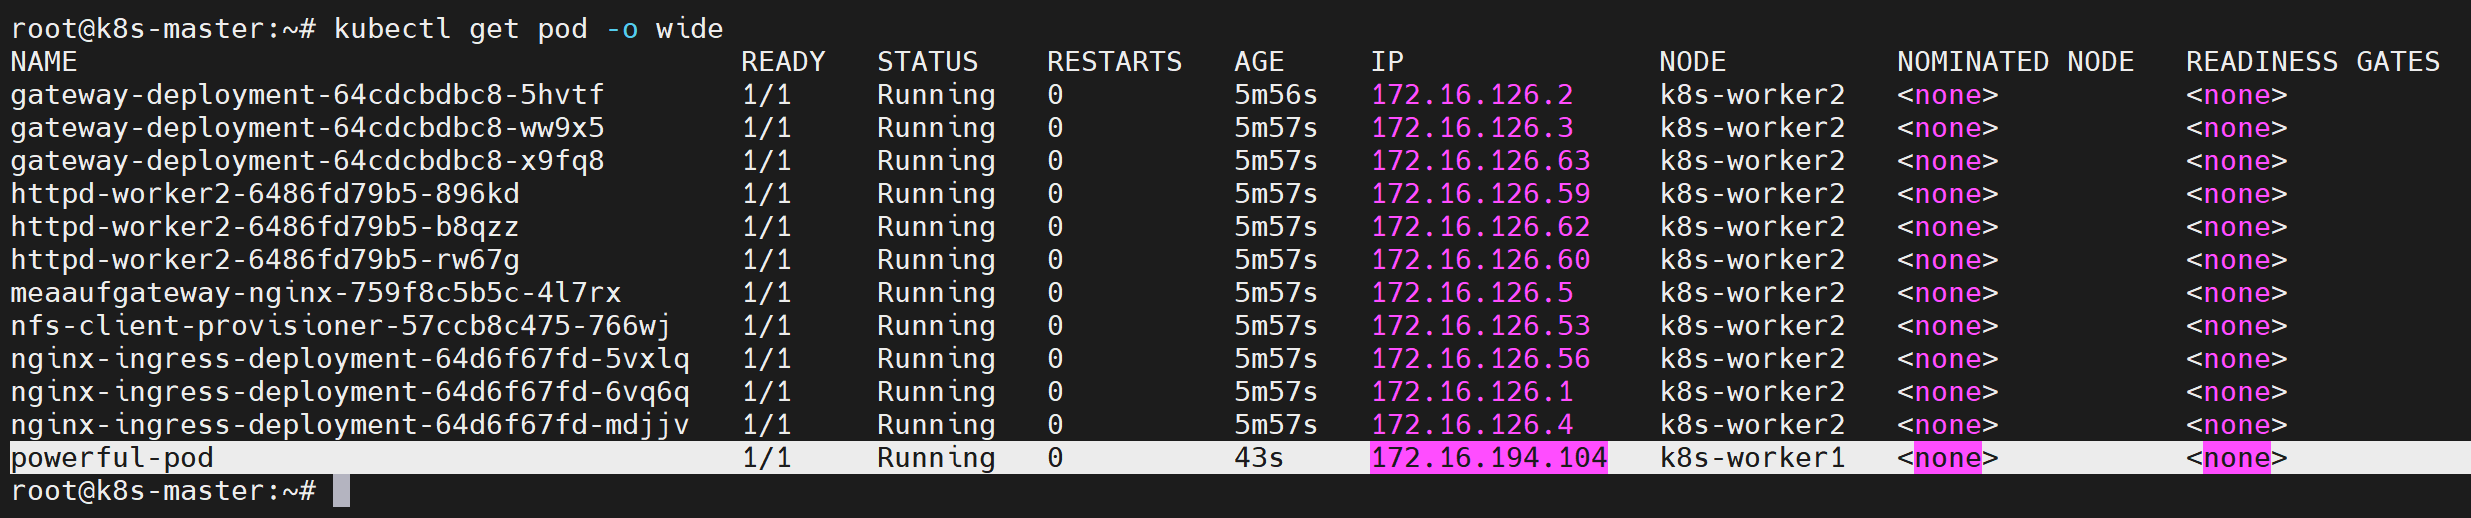
4. 仅忽略特定污点
[Step1] 本地新建YAML清单,定义Pod资源描述模板。
root@k8s-master:~# vim ignore-pod.yml
# 写入下列内容
apiVersion: v1 # 固定语法
kind: Pod # 资源类型
metadata:
name: ignore-pod
spec:
tolerations: # 容忍度配置
- key: "maintain" # 匹配的污点键名
operator: "Equal" # 容忍度运算符,要求污点value和下面value一致
value: "true" # 匹配的污点值
# 不配置effect,自动匹配 NoSchedule、PreferNoSchedule、NoExecute
containers:
- name: busybox
image: busybox:latest
imagePullPolicy: IfNotPresent
command: ["sleep","10000"]
nodeName: k8s-worker1[Step2] 基于YAML清单向Kubernetes集群声明式地创建Pod资源。
root@k8s-master:~# kubectl create -f ignore-pod.yml[Step3] 验证:查看当前命名空间下所有的Pod,可以看到Pod已无视污点被调度到k8s-worker1上。
root@k8s-master:~# kubectl get pod -o wide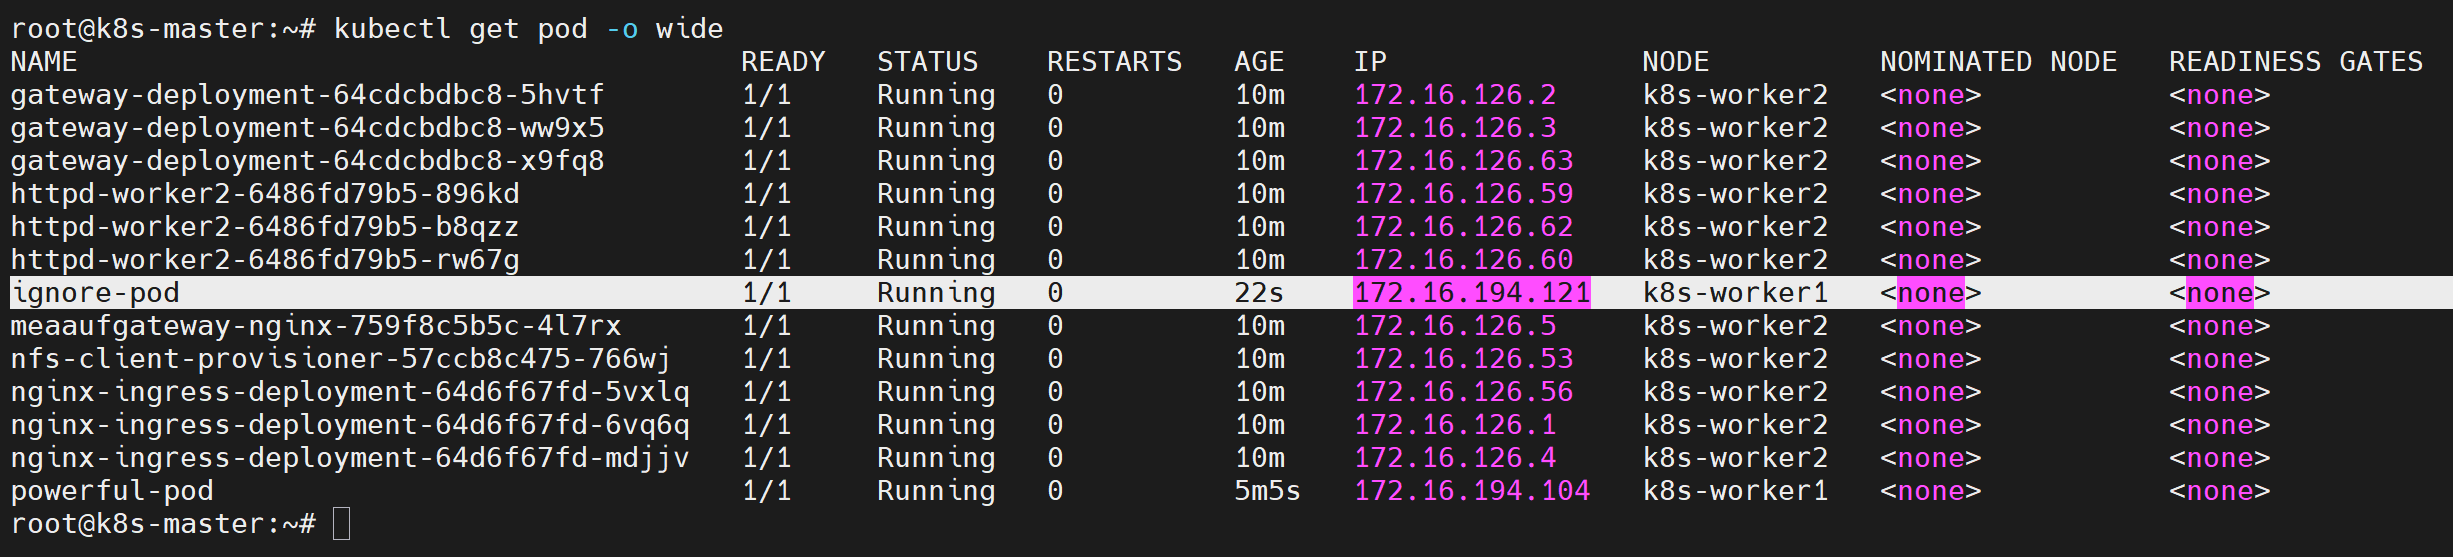
八、PriorityClass基础案例
1. PriorityClass创建
[Step1] 本地新建YAML清单,定义PriorityClass资源描述模板。
root@k8s-master:~# vim pc-normal.yml
# 写入下列内容
apiVersion: scheduling.k8s.io/v1 # 固定语法
kind: PriorityClass # 资源类型
metadata:
name: pc-normal
# 优先级数值,业务建议0~1000000000,此处50000为中等优先级
value: 50000
globalDefault: true # 是否作为集群全局默认优先级
# 抢占策略:PreemptLowerPriority代表资源不足时,可驱逐优先级更低的Pod释放资源
preemptionPolicy: PreemptLowerPriority
description: "常规业务-中等优先" # 描述字段[Step2] 基于YAML清单向Kubernetes集群声明式地创建PriorityClass资源。
root@k8s-master:~# kubectl create -f pc-normal.yml[Step3] 验证:查看当前集群中所有的优先级类,可以看到上述操作创建的优先级类。
root@k8s-master:~# kubectl get priorityclasses.scheduling.k8s.io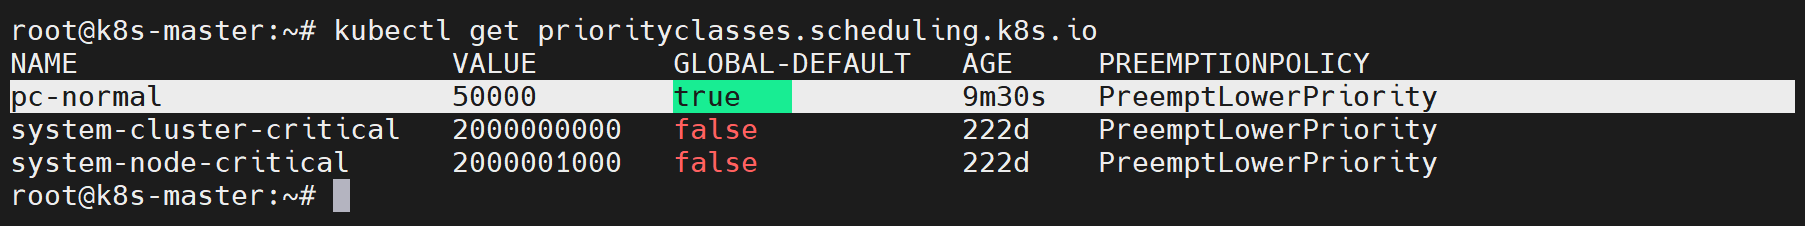
2. 创建Pod引用优先级
[Step1] 本地新建YAML清单,定义Pod资源描述模板。
root@k8s-master:~# vim pc-normal-pod.yml
# 写入下列内容
apiVersion: v1 # 固定语法
kind: Pod # 资源类型
metadata:
name: pc-normal-pod
spec:
priorityClassName: pc-normal # 引用优先级
containers:
- name: busybox
image: busybox:latest
imagePullPolicy: IfNotPresent
command: ["sleep","10000"][Step2] 基于YAML清单向Kubernetes集群声明式地创建Pod资源。
root@k8s-master:~# kubectl create -f pc-normal-pod.yml[Step3] 验证:基于文件内定义的资源清单,查询集群中该资源的运行状态与基础信息。
root@k8s-master:~# kubectl get -f pc-normal-pod.yml
[Step4] 验证:查看pc-normal-pod的详细信息,可以看到Priority字段值为50000。
root@k8s-master:~# kubectl describe pod pc-normal-pod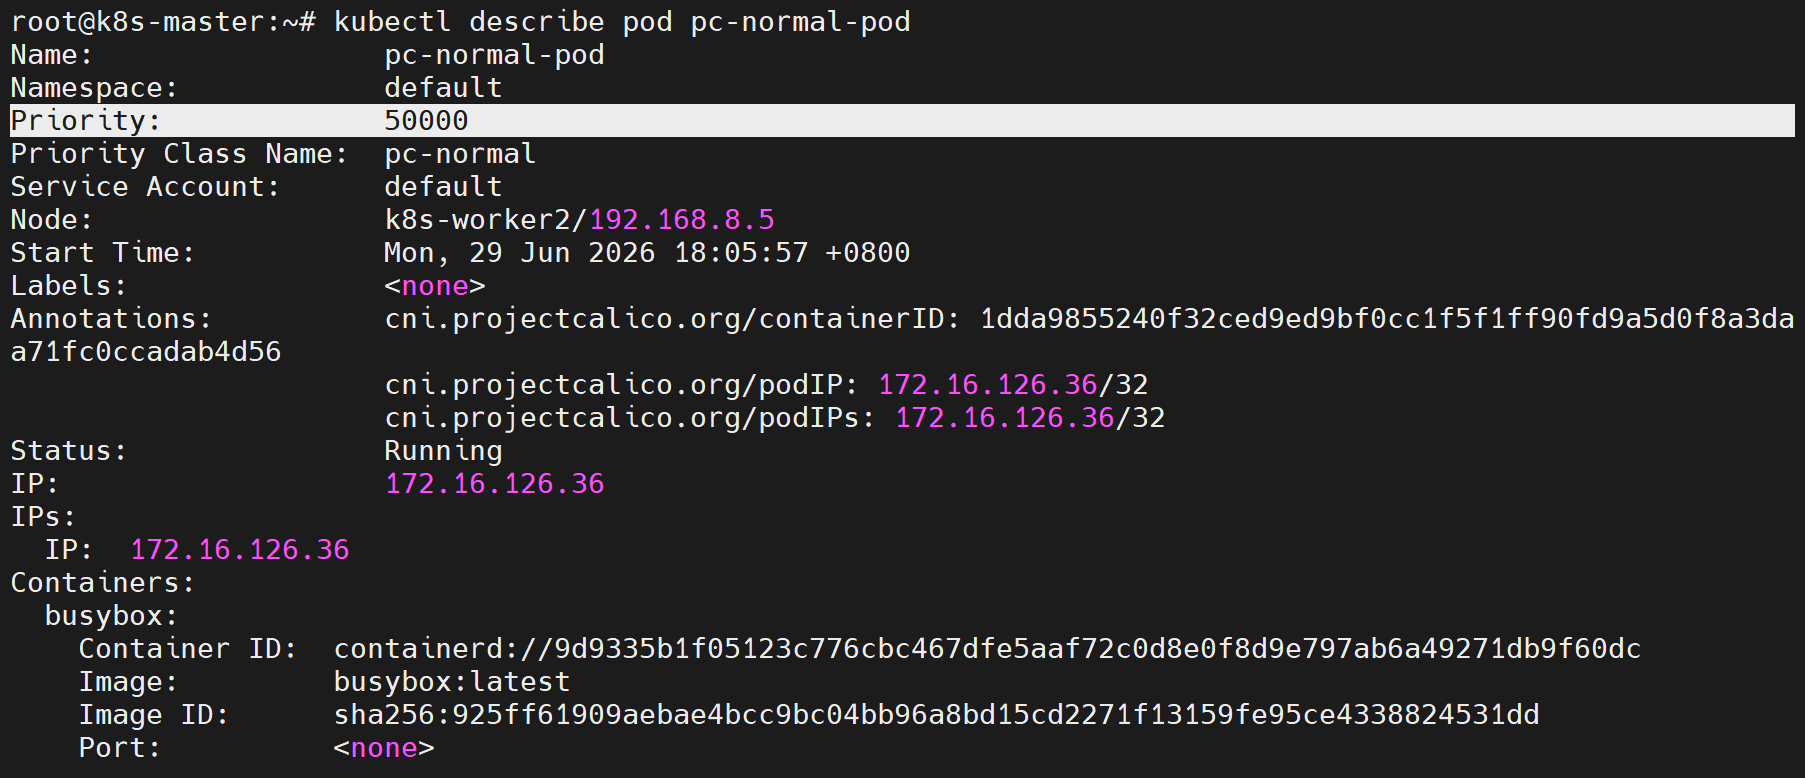
3. 验证默认优先级
[Step1] 本地新建YAML清单,定义Pod资源描述模板。
root@k8s-master:~# vim pc-normal-default-pod.yml
# 写入下列内容
apiVersion: v1 # 固定配置
kind: Pod # 资源类型
metadata:
name: default-pod
spec:
containers:
- name: busybox
image: busybox:latest
imagePullPolicy: IfNotPresent
command: ["sleep","10000"][Step2] 基于YAML清单向Kubernetes集群声明式地创建Pod资源。
root@k8s-master:~# kubectl create -f pc-normal-default-pod.yml[Step3] 验证:基于文件内定义的资源清单,查询集群中该资源的运行状态与基础信息。
root@k8s-master:~# kubectl get -f pc-normal-default-pod.yml
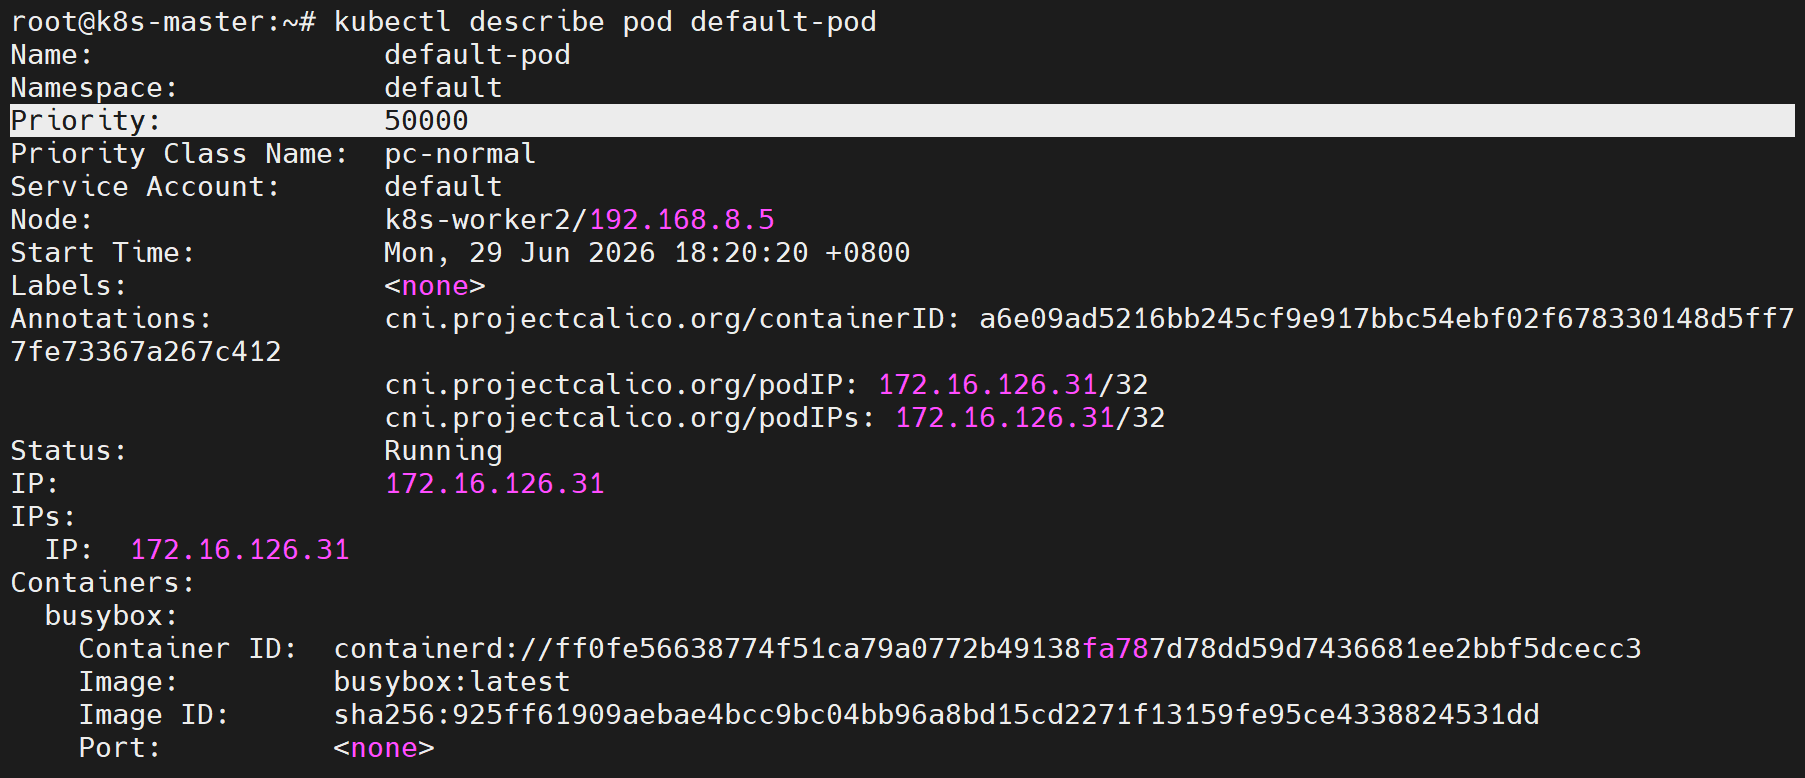
[Step4] 验证:查看default-pod的详细信息,可以看到Priority字段值为50000。这是因为我们将“globalDefault: true”,当我们创建Pod时未显式指定priorityClassName,则会自动引用该值。
root@k8s-master:~# kubectl describe pod default-pod