
一、Pod探针基本概念
1. Pod状态
Pod的状态信息是在PodStatus中定义,其中有一个phase字段。phase字段是PodStatus中的核心字段,代表Pod在其生命周期中的宏观运行阶段,是Kubernetes自动为Pod标记的简要状态摘要,能够反馈Pod的运行情况。
2. 探测器概述
Kubernetes借助探针机制,探针会周期性监测容器运行的状态,并返回结果。
2.1 启动探针(startup probes)
启动探针用于检测容器启动状态,可以延迟存活探针、就绪探针的执行时机,等待容器完全启动后再开启检测。该机制适用于启动缓慢的应用,能够有效防止容器还未启动就被误终止的情况。
2.2 存活探针(liveness probes)
存活探针用于捕获容器的状态是否处于存活状态,如检测端口、配置等业务必备资源。如果探测失败,kubelet会根据重启策略尝试恢复容器。
2.3 就绪探针(readiness probes)
Pod处于存活状态并不意味着可以提供服务,创建完成后通常需要进行诸如数据准备、安装和运行程序等步骤,才能对外提供服务。
就绪探针用于检测容器是否具备接收业务流量的能力。如果探测失败,kubelet会判定容器未就绪。仅当Pod内所有容器全部就绪,该Pod才会被标记为就绪状态。
Endpoint Controller依据就绪探针结果管理Service端点,只有通过就绪探测的Pod才会被纳入Service后端端点列表。未就绪的Pod会被从端点列表中移除,不再承接业务流量。
3. 容器探针
kubelet作为节点上的核心组件,会按照预设时间周期对容器发起健康诊断,以此持续监控容器的运行状态。容器诊断功能依托探测处理器(Handler)实现。kubelet通过调用容器对应的处理器完成检测,Kubernetes一共提供三种标准处理器类型,可以根据业务场景灵活选用。
3.1 ExecAction(命令执行探测)
ExecAction会进入容器内部,执行预先定义的Shell命令或可执行程序。检测结果以命令执行后的退出返回码作为判断依据。如果命令正常结束且返回码为0,代表容器健康,诊断结果为成功。如果返回码为非0或命令执行超时,则判断探测失败。通常用于检测容器内进程、文件、目录、服务状态等底层运行情况。
3.2 TCPSocketAction(TCP端口探测)
基于网络层进行检测,kubelet主动向容器IP地址与指定端口发起TCP连接请求。如果能够正常建立TCP连接,说明端口处于监听状态、网络正常,诊断判定为成功。如果连接超时、被拒绝,则视为探测失败。多用于检测TCP类服务,例如数据库、消息队列、后端服务端口可用性。
3.3 HTTPGetAction(HTTP请求探测)
针对Web类应用设计,kubelet向容器IP、指定端口及接口路径发起标准HTTP GET请求。系统通过HTTP响应状态码判断健康状态。当返回码介于200~399之间时,认定应用探测成功,正常响应。如果返回4xx、5xx错误码,或者是请求超时、连接异常,均判定为探测失败。普遍用于检测Nginx、Tomcat、微服务等HTTP/WEB应用。
4. 存活探针与就绪探针区别
就绪探针和存活探针一样,可以使用ExecAction、TCPSocketAction、HTTPGetAction三种方法。就绪探针用于检测和显示Pod是否已经准备好对外提供业务。在实际应用场景中,就绪探针需要和业务绑定。
5. 启动探测器保护慢启动容器
部分应用启动初始化耗时较长,为了兼顾启动耗时与故障快速检测,需要合理配置探针参数。可以通过启动探针配合存活探针协同工作。对应HTTP、TCP类型探测,可以通过“failureThreshold x periodSeconds”计算出应用最长启动容忍时长。
以阈值3、探测间隔10秒为例,应用最长拥有30秒完成初始化。启动探针探测成功后,将由存活探针接管健康检测,可以及时发现容器死锁等异常。如果启动探针始终探测失效,容器将在30秒后被终止,并按照Pod重启策略执行后续动作。
6. Probe常用参数
7. 探针检测顺序
在Kubernetes体系中,三种探针会依据容器生命周期各司其职,执行顺序存在明确规则:
启动探针(Startup Probes) > 存活探针(Liveness Probes)、就绪探针(Readiness Probes)启动探针具备最高执行优先级,如果容器配置启动探针,只有当启动探针校验通过后,存活探针和就绪探针才会开启检测。启动探针未通过校验时,另外两个探针不会运行。启动探针校验通过后,存活探针、就绪探针会同步启动,二者无先后执行顺序。
7.1 启动探针
检测顺序:容器刚启动时最先执行,仅在应用启动阶段生效。
调度优先级:如果配置启动探针,在其校验成功前,存活探针、就绪探针全部暂停不执行。启动探针校验通过后,存活探针和就绪探针同步开始循环探测。
核心作用:适配启动耗时久的应用,避免应用尚未初始化完成,就被存活探针判定异常、误重启容器。
7.2 存活探针
检测顺序:存在启动探针时,存活探针需要等待启动探针校验成功后才启动周期性探测;未配置启动探针时,容器启动完毕后存活探针立即开始探测。
处理逻辑:一旦存活探针连续探测失败,Kubernetes将直接重启当前容器。
7.3 就绪探针
检测顺序:存在启动探针时,就绪探针需要等待启动探针校验成功后才启动周期性探测。未配置启动探针时,容器启动完成后就绪探针立即运行。
处理逻辑:如果就绪探针多次探测失败,该Pod会被从Service后端端点列表剔除,并停止分配业务流量。
8. 优雅关闭
从Kubernetes 1.22版本开始,“terminationGracePeriodSeconds”机制正式生效。当触发Pod终止流程时,集群会首先切断流向该Pod的新业务流量,但是Pod内正在运行的容器进程不会被立即终止。容器将继续运行,直至设定的超时时间结束。k8s遵循一套先发信号→等待超时→强制销毁的流程。
preStop是Kubernetes容器生命周期钩子,在容器收到终止信号前优先执行一段自定义指令,属于优雅关闭流程的第一环节。需要注意的是,preStop运行时长会计入“terminationGracePeriodSeconds”总时长。如果钩子执行太久耗尽超时时,会直接被SIGKILL中断。
8.1 优雅关闭流程
控制器/用户删除Pod,Pod状态变更为“Termination”,从Service端点剔除,不再接收新流量;
kubelet向容器主进程发送“SIGTERM(15)”信号(Linux的默认终止信号),并执行preStop钩子;
容器应用收到“SIGTERM”自行执行后续操作,如关闭连接、销毁子进程等;
等待优雅关闭超时时间,如果超时未退出,kubelet发送“SIGKILL(9)”信号强制杀死容器,回收资源。
二、存活探针基础案例配置
1. 命令执行探测案例
[Step1] 本地新建YAML清单,定义Pod资源描述模板。配置存活探测规则,kubelet每5秒执行一次存活探测,容器首次探测等待5秒。探测方式:在容器内部执行命令“cat /tmp/healthy”以检查容器健康状态。
root@k8s-master:~# vim file-liveness-probes.yml
# 写入下列内容
apiVersion: v1 # 固定配置
kind: Pod # 资源类型
metadata:
name: file-liveness-probes
spec:
containers:
- name: file-liveness
image: busybox:latest
imagePullPolicy: IfNotPresent
args:
- /bin/sh
- -c
- touch /tmp/healthy;sleep 3600
livenessProbe: # 配置存活探针
exec: # 使用命令行探测方式
command: # 容器内执行:cat /tmp/healthy
- cat
- /tmp/healthy
initialDelaySeconds: 5 # 容器启动后等待5秒执行第一次探针
periodSeconds: 5 # 探针每隔5秒执行一次探测[Step2] 基于YAML清单向Kubernetes集群声明式地创建Pod资源。
root@k8s-master:~# kubectl create -f file-liveness-probes.yml[Step3] 验证:查看当前集群中的所有Pod资源。
root@k8s-master:~# kubectl get pods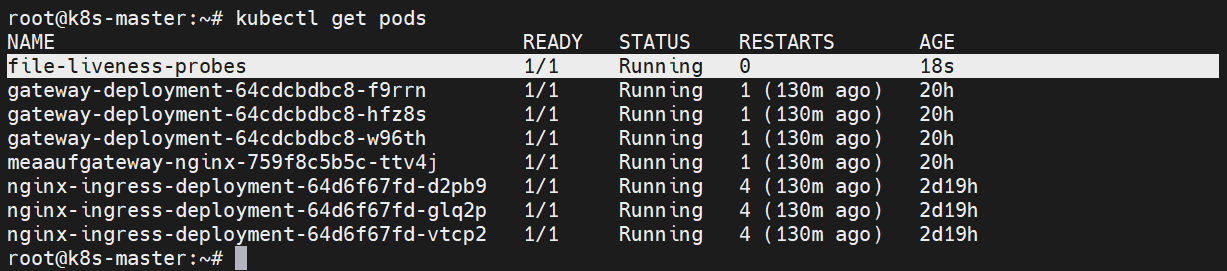
[Step4] 执行命令删除“/tmp/healthy”文件,随后重新查看Pod状态。可以看到Pod的重启次数加一,状态恢复为正常运行状态。原因是存活探针检测不到文件存在后判定容器异常,触发容器重启。容器重启后重新执行启动命令,自动新建“/tmp/healthy”文件,探测检测恢复正常。
root@k8s-master:~# kubectl exec file-liveness-probes -- rm /tmp/healthy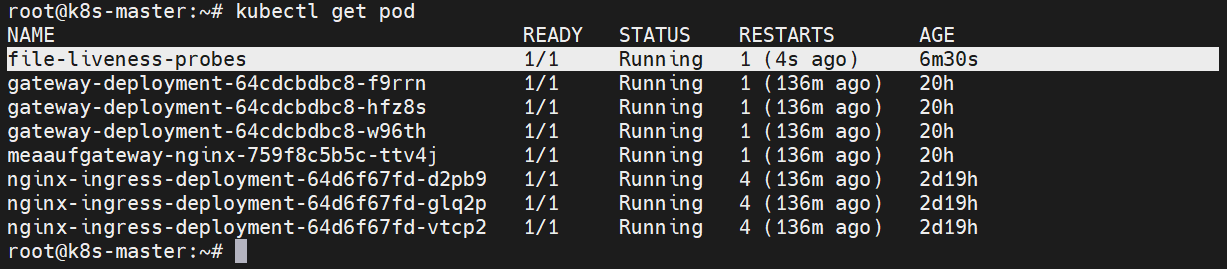
[Step5] 验证:查看Pod的事件日志,可以看到探针探测文件是否存在后执行的操作全流程。
root@k8s-master:~# kubectl describe pod file-liveness-probes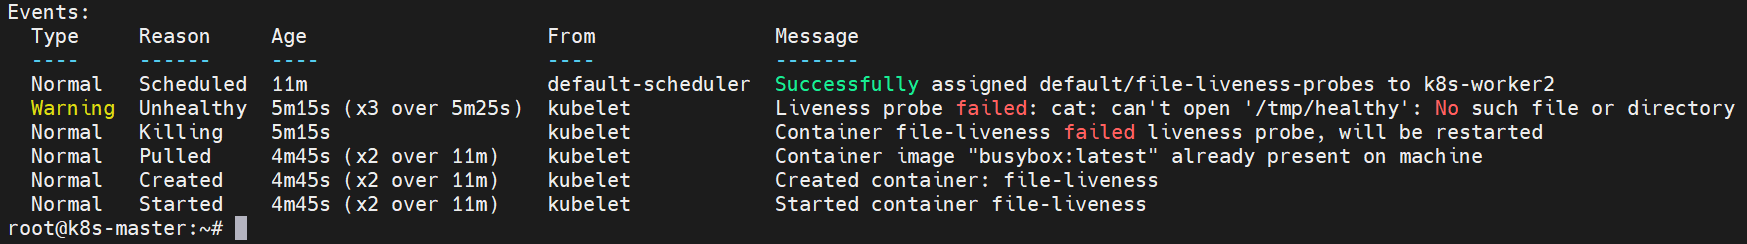
2. HTTP请求探测案例
[Step1] 本地新建YAML清单,定义Pod资源描述模板。配置存活探测规则,kubelet每5秒执行一次存活探测,容器首次探测等待5秒。探测方式:向容器内服务指定路径“/PATH”路径发起HTTP GET请求。如果服务返回正常状态码,则判定容器健康存活。
root@k8s-master:~# vim http-liveness-probes.yml
# 写入下列内容
apiVersion: v1 # 固定配置
kind: Pod # 资源类型
metadata:
name: http-liveness-probes
spec:
containers:
- name: http-liveness
image: httpd:latest
imagePullPolicy: IfNotPresent
livenessProbe: # 配置存活探针
httpGet: # 使用HTTP Get探测方式
path: / # HTTP探测的请求路径
port: 80 # HTTP探测使用的端口号
httpHeaders: # 自定义HTTP请求头
- name: User-Agent # 标记这是k8s探针请求,方便后续日志区分、监控识别
value: "kubelet/liveness-probe"
initialDelaySeconds: 5 # 容器启动后等待5秒执行第一次探针
periodSeconds: 3 # 探针每隔3秒执行一次探测
restartPolicy: OnFailure # Pod重启策略,仅在容器异常/失败时重启[Step2] 基于YAML清单向Kubernetes集群声明式地创建Pod资源。
root@k8s-master:~# kubectl create -f http-liveness-probes.yml[Step3] 验证:查看当前集群中的所有Pod资源。
root@k8s-master:~# kubectl get pods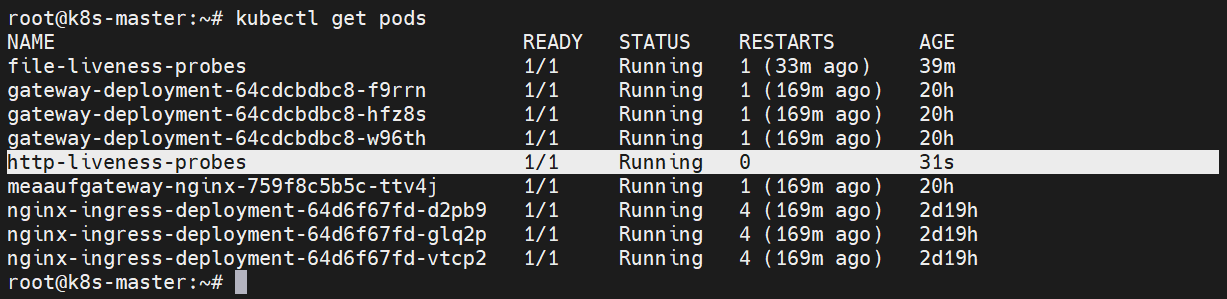
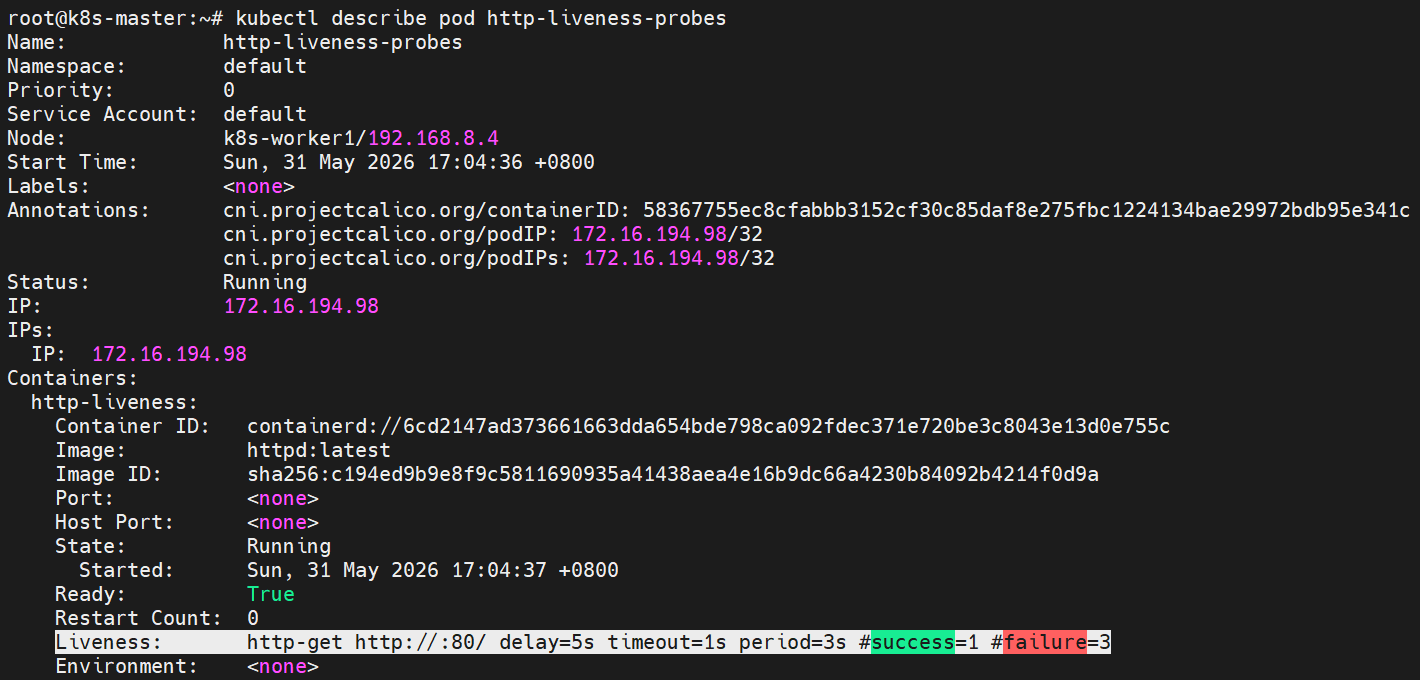
[Step4] 验证:查看Pod的事件日志中的“Liveness”字段,能够看到容器配置了HTTP存活探针,kubelet将在容器启动5秒后,每隔3秒向容器的根路径发起HTTP GET监控探测,检测超时1秒,连续1次探测成功则判断健康,连续3次探测失败则重启容器。
root@k8s-master:~# kubectl describe pod http-liveness-probesdelay=5s:表示探针在容器启动后5秒进行第一次探测
timeout=1s:表示容器必须在1秒内反馈信息给探针,否则视为失败
period=3s:表示每3秒探针进行一次探测
#success=1:表示探测连续成功1次,判定为成功
#failure=3:表示探测连续失败3次,视为Pod处于failure状态,重启容器
3. TCP端口探测案例
[Step1] 本地新建YAML清单,定义Pod资源描述模板,同时使用就绪探测器和存活探测器。
配置就绪探测规则,kubelet在容器启动5秒后发送第一个就绪探测,每隔10秒执行一次就绪探测,尝试连接容器的80端口,如果探测成功标记为就绪状态。
配置存活探测规则:kubelet在容器启动10秒后发送第一个就绪探测,尝试连接容器的80端口。如果存活探测失败,重新启动容器。
root@k8s-master:~# vim tcp-liveness-probes.yml

# 写入下列内容
apiVersion: v1		# 固定配置
kind: Pod			# 资源类型
metadata:
  name: tcp-liveness-probes
spec:
  containers:
    - name: tcp-livenes
      image: httpd:latest
      imagePullPolicy: IfNotPresent
      ports:		# 声明容器暴露的端口
        - name: httpport		# 端口名称
          protocol: TCP			# 协议
          containerPort: 80		# 容器内部端口
      readinessProbe:	# 配置就绪探针
        tcpSocket:		# 使用TCP端口探测
          port: 80		# 探测容器80端口
        initialDelaySeconds: 5	# 容器启动后等待5秒执行第一次探针
        periodSeconds: 10		# 探针每隔10秒执行一次探测
      livenessProbe:	# 配置存活探针
        tcpSocket:		# 使用TCP端口探测
          port: 80		# 探测容器80端口
        initialDelaySeconds: 10	# 容器启动后等待10秒执行第一次探针
        periodSeconds: 20		# 探针每隔20秒执行一次探测
  restartPolicy: OnFailure		# Pod重启策略,仅在容器异常/失败时重启
[Step2] 基于YAML清单向Kubernetes集群声明式地创建Pod资源。
root@k8s-master:~# kubectl create -f tcp-liveness-probes.yml[Step3] 验证:查看当前集群中的所有Pod资源。
root@k8s-master:~# kubectl get pods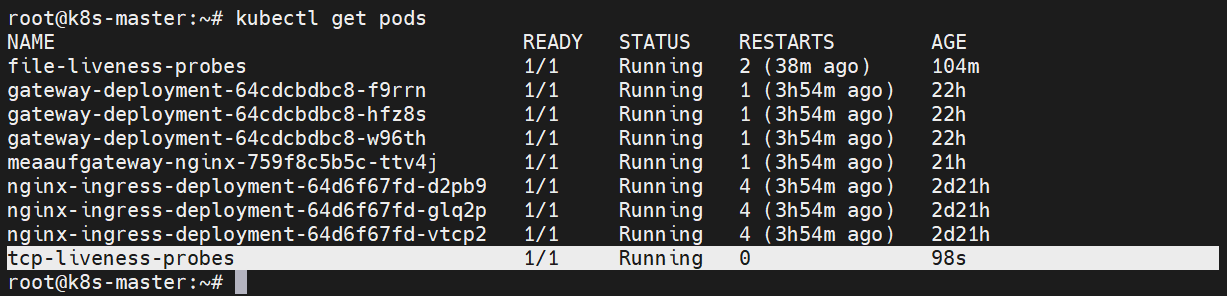
三、优雅关闭基础案例
[Step1] 本地新建YAML清单,定义Pod资源描述模板,同时使用就绪探测器和存活探测器。
root@k8s-master:~# vim terminationGracePeriodSeconds.yml
# 写入下列内容
apiVersion: v1 # 固定配置
kind: Pod # 资源类型
metadata:
name: grace-pod
spec:
terminationGracePeriodSeconds: 100 # 优雅关闭总超时时间
containers:
- name: httpd
image: httpd:latest
imagePullPolicy: IfNotPresent
ports: # 声明容器暴露的端口
- name: httpport # 端口名称
protocol: TCP # 协议
containerPort: 80 # 容器内部端口
lifecycle: # 容器生命周期钩子配置
preStop: # 终止前置钩子
exec: # 执行命令方式运行钩子
# 执行Shell命令,休眠1分钟
command: ["/bin/sh","-c","sleep 1m"]
restartPolicy: OnFailure # Pod重启策略,只有容器异常退出时才重启[Step2] 基于YAML清单向Kubernetes集群声明式地创建Pod资源。
root@k8s-master:~# kubectl create -f terminationGracePeriodSeconds.yml[Step3] 验证:查看当前集群中的所有Pod资源。
root@k8s-master:~# kubectl get pods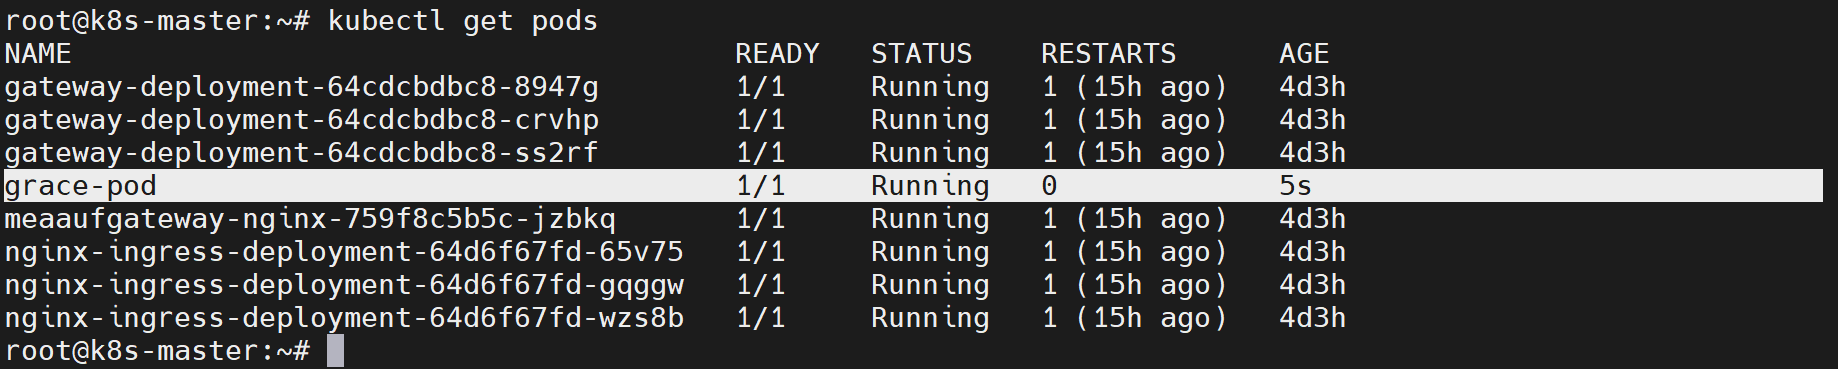
[Step4] 验证:删除grace-pod Pod,搭配&符号将命令放置在后台允许,便于我们观察删除过程。
root@k8s-master:~# kubectl delete pod grace-pod & [Step5] 验证:查询集群内grace-pod的运行状态,可以看到Pod状态变为“Terminating”。
root@k8s-master:~# kubectl get pods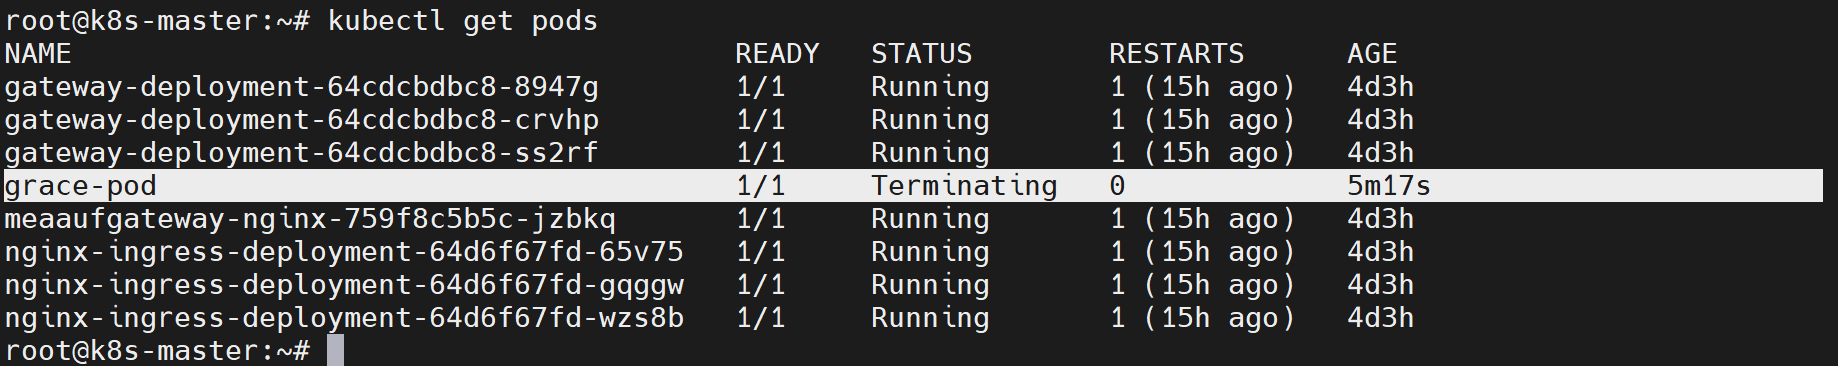
[Step6] 验证:等待优雅关闭超时时长耗尽后,Pod会被完整清除。
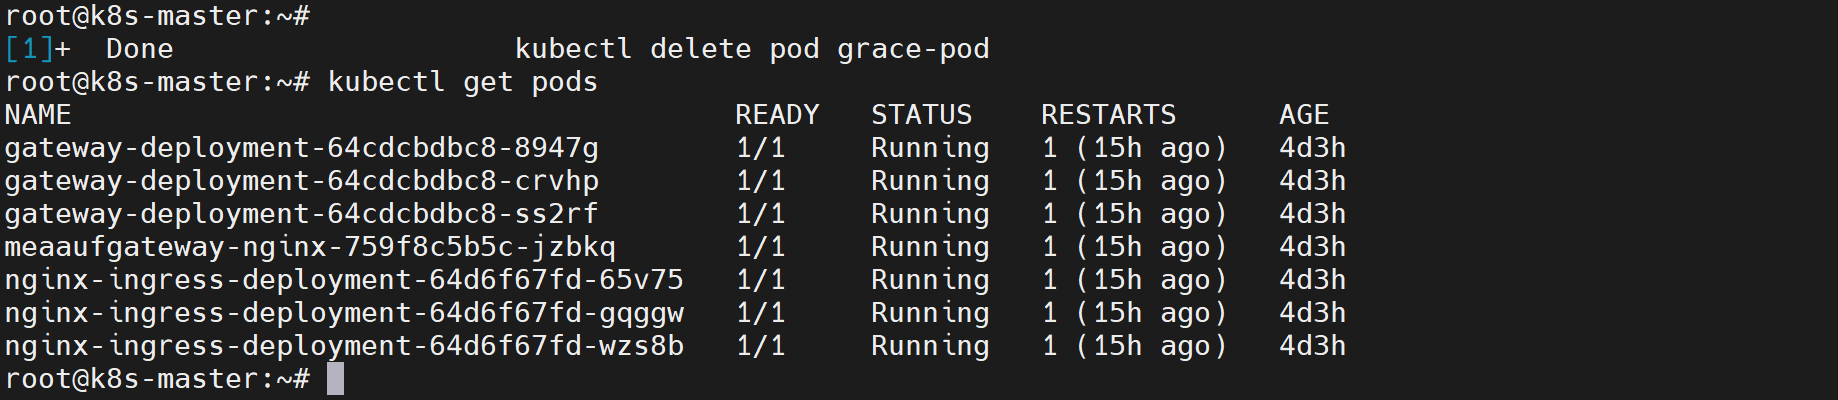
root@k8s-master:~# kubectl get pods