
一、Kubernetes监控方案
1. 监控概述
Kubernetes能够在节点、Pod、容器等多个层级提供应用资源占用的详细信息。依托这些监控数据,运维人员可以评估应用运行性能,定位系统瓶颈并进行优化,以此提升集群整体运行效率。
资源指标管道为集群组件提供基础监控数据,支撑水平Pod自动扩缩器(Horizontal Pod Autoscaler)、kubelet top命令等功能使用。这类指标由轻量化组件Metrics Server采集,数据仅短期保存在内存中,不进行持久化存储,指标通过metrics.k8s.io API对外暴露。
2. Heapster
Heapster是Kubernetes早期官方推出的集群资源指标聚合组件,充当集群监控数据的汇总中心,统一采集节点、Pod与容器的运行资源指标。Kubernetes内置了监控代理组件cAdvisor,能够采集容器运行产生的各类核心监控指标(Metrics),包含CPU使用率、内存占用、网络流量等关键数据。
Heapster从集群控制平面获取全部节点信息,再与各节点上的kubelet建立通信拉取监控数据。而kubelet的指标数据,正是源自节点本地运行的cAdvisor。采集完成后,Heapster将指标推送至预先配置的后端存储,同时支持对接可视化组件展示监控信息。
该组件目前已经正式退役(Retired),自Kubernetes1.11版本起被标记为废弃,社区不再持续维护,新项目不建议部署使用。
2.1 工作架构与采集流程
数据源:集群每个节点上kubelet内置cAdvisor,持续采集容器CPU、内存、网络、磁盘资源占用指标。
指标汇总:Heapster以Pod形式部署,自动发现集群所有节点,主动从各节点kubelet拉取监控指标,并按照Namespace、Pod、容器维度聚合数据。
数据输出:支持可插拔的后端存储(Sink),常见搭配“Heapster+InfluxDB+Grafana”,指标持久存入时序数据库,通过Grafana实现可视化展现。
对外能力:对外提供REST接口,早期为kubectl top命令、HPA(水平Pod自动扩缩容)控制器提供资源指标数据。
2.2 主要缺陷和淘汰问题
架构设计问题:Heapster 采用集中式单点部署,集群规模增大后容易出现性能瓶颈,存在单点故障风险。
API 不标准:自定义指标接口,不属于Kubernetes标准API体系,扩展性差。
功能定位耦合:同时承担指标聚合、数据推送、历史存储转发多重职责,组件臃肿。
社区停止维护:社区拆分需求:基础资源指标由Metrics Server承接;长期监控、指标持久化交给Prometheus等专业时序系统。
3. Weave Scope
Weave Scope是Weaveworks推出的开源容器可视化监控工具,适配Docker和Kubernetes环境。核心优势是自动发现集群资源并生成交互式网络拓扑图,直观展示节点、Pod、容器、进程之间的网络连接与调用关系。该工具由Probe采集探针与Scope App聚合服务两部分组成。
Probe一般以DaemonSet形式部署在各个节点,负责采集CPU、内存、网络流量等运行指标与资源元数据,汇总至中心App后通过Web界面对外提供可视化视图。运维人员可以在页面中查看资源实时性能指标、筛选检索集群对象,还支持直接在浏览器打开容器终端进行调试,实现容器启停等基础管理操作。
Weave Scope侧重集群实时拓扑观测与临时故障排查,适合快速梳理微服务依赖关系,但不具备长期指标持久存储、告警能力,多用于实验环境与临时问题定位,生产环境一般搭配Prometheus等专业监控系统使用。
4. Prometheus
Heapster与Weave Scope的监控对象主要聚焦节点与业务Pod,难以实现集群控制平面自身运行状态的监控,无法获取APIServer、Scheduler、ControllerManager等核心管理组件的健康状态与负载情况。
Prometheus是由SoundCloud推出的开源监控解决方案,项目始于2012年,2015年正式在GitHub开源;2016年正式加入CNCF,是继Kubernetes之后第二个成为CNCF托管项目的成员。
二、Metrics与HPA
1. Metrics Server概述
Metrics Server是Kubernetes集群核心组件之一,属于轻量级指标聚合服务。它会从集群各个节点的kubelet获取cAdvisor采集到的容器资源运行数据,汇总、聚合节点、Pod、容器的基础资源指标,主要包含CPU与内存占用信息。Metrics通常以无状态Pod形式部署在Kubernetes集群内部,需要配置对应的ServiceAccount、RBAC权限,保证能够访问各个节点kubelet获取监控数据。
Heapster是Kubernetes早期官方指标聚合组件,目前已经正式废弃。它采用集中式架构,支持对接InfluxDB等时序数据库实现指标持久化存储。自Kubernetes 1.8起,Metrics Server成为Heapster的替代方案,架构更加轻量化,职责更加单一,仅对外提供标准API输出实时资源指标,不再具备数据持久化存储能力。
Metrics Server对外通过“metrics.k8s.io”API提供标准资源指标,是集群基础监控能力的关键支撑。Metrics Server仅在内存中临时保存实时指标,不会持久化存储历史监控数据,只提供短时基础指标,无法实现长期性能趋势分析。如果需要持久存储、指标监控、大盘可视化,则需要部署Prometheus等监控方案。
2. Metrics核心作用
2.1 支撑kubelet top命令
“kubectl top node”、“kubectl top pod”获取节点与Pod实时资源使用率,底层数据全部源自于Metrics Server。没有部署Metrics Server时,该命令无法使用。

2.2 支撑HPA(Horizontal Pod Autoscaler,水平Pod自动扩缩容)
原生HPA根据CPU、内存负载自动扩缩Pod副本,依赖metrics.k8s.io获取实时资源指标,Metrics Server是原生HPA正常运行的必要条件。
3. HPA自动扩容
HPA(Horizontal Pod Autoscaler,水平Pod自动扩缩器)是Kubernetes内置原生控制器。它持续采集Pod负载指标,依据预设阈值自动调整Deployment、StatefulSet资源的Pod副本数量,实现应用弹性伸缩。
水平扩容(Horizontal):通过增加/减少Pod副本数量实现扩容,新增或销毁应用实例,HPA仅支持水平扩缩容。
垂直扩容(VPA,Vertical Pod Autoscaler):调整单个Pod的CPU、内存资源配额,不会改变Pod副本数量。
HPA控制器会周期性从指标数据源中拉取Pod实时负载,将当前负载与配置的目标阈值进行对比,计算出合理的副本数量,并自动更新Deployment和StatefulSet的副本数,完成扩容或缩容操作。同时扩缩容动作设置了冷却时间,避免指标短暂波动造成副本频繁震荡。
HPA支持两类主流指标数据源:基础资源指标(CPU、内存)与自定义业务指标。
基础资源指标:依赖Metrics Server提供数据,若集群未部署Metrics Server,基于CPU、内存的HPA策略无法生效。
自定义指标:如接口QPS、并发连接数等业务层面指标,一般依靠Prometheus搭配Prometheus Adapter对外暴露指标供HPA调用。
4. 常见维护操作
三、Metrics部署
如果无法正常下载,可以访问我提供的百度云链接下载。
Metrics组件包链接: https://pan.baidu.com/s/1ZSO3Cf9a7mDAuCWjkuhhuw?pwd=cu3y
提取码: cu3y
[Step1] 从GitHub上下载Metrics Server官方描述文件,其实也可以使用“kubectl apply -f”一步下载和导入,但是为了方便区分安装错误的原因,这里将下载和导入步骤分开进行。
root@k8s-master:~# wget https://gh-proxy.org/https://github.com/kubernetes-sigs/metrics-server/releases/download/v0.8.1/components.yaml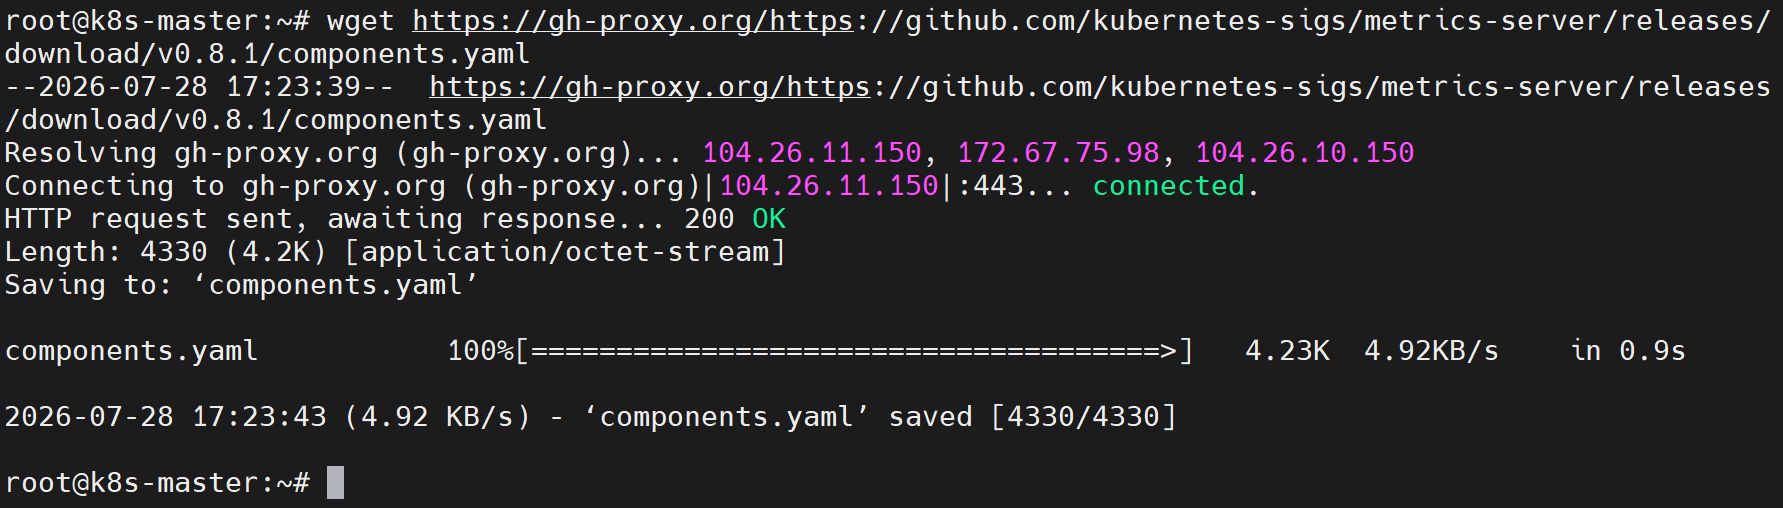
[Step2] 默认情况下,Metrics Server访问各节点kubelet时,校验kubelet自签名证书。自建kubeadm集群节点kubelet证书CN不包含节点IP,证书校验会失败,无法采集指标,服务内部报错。这里需要添加启动参数增加跳过kubelet证书校验。
root@k8s-master:~# vim components.yaml
# 在args参数下增加一行
- --kubelet-insecure-tls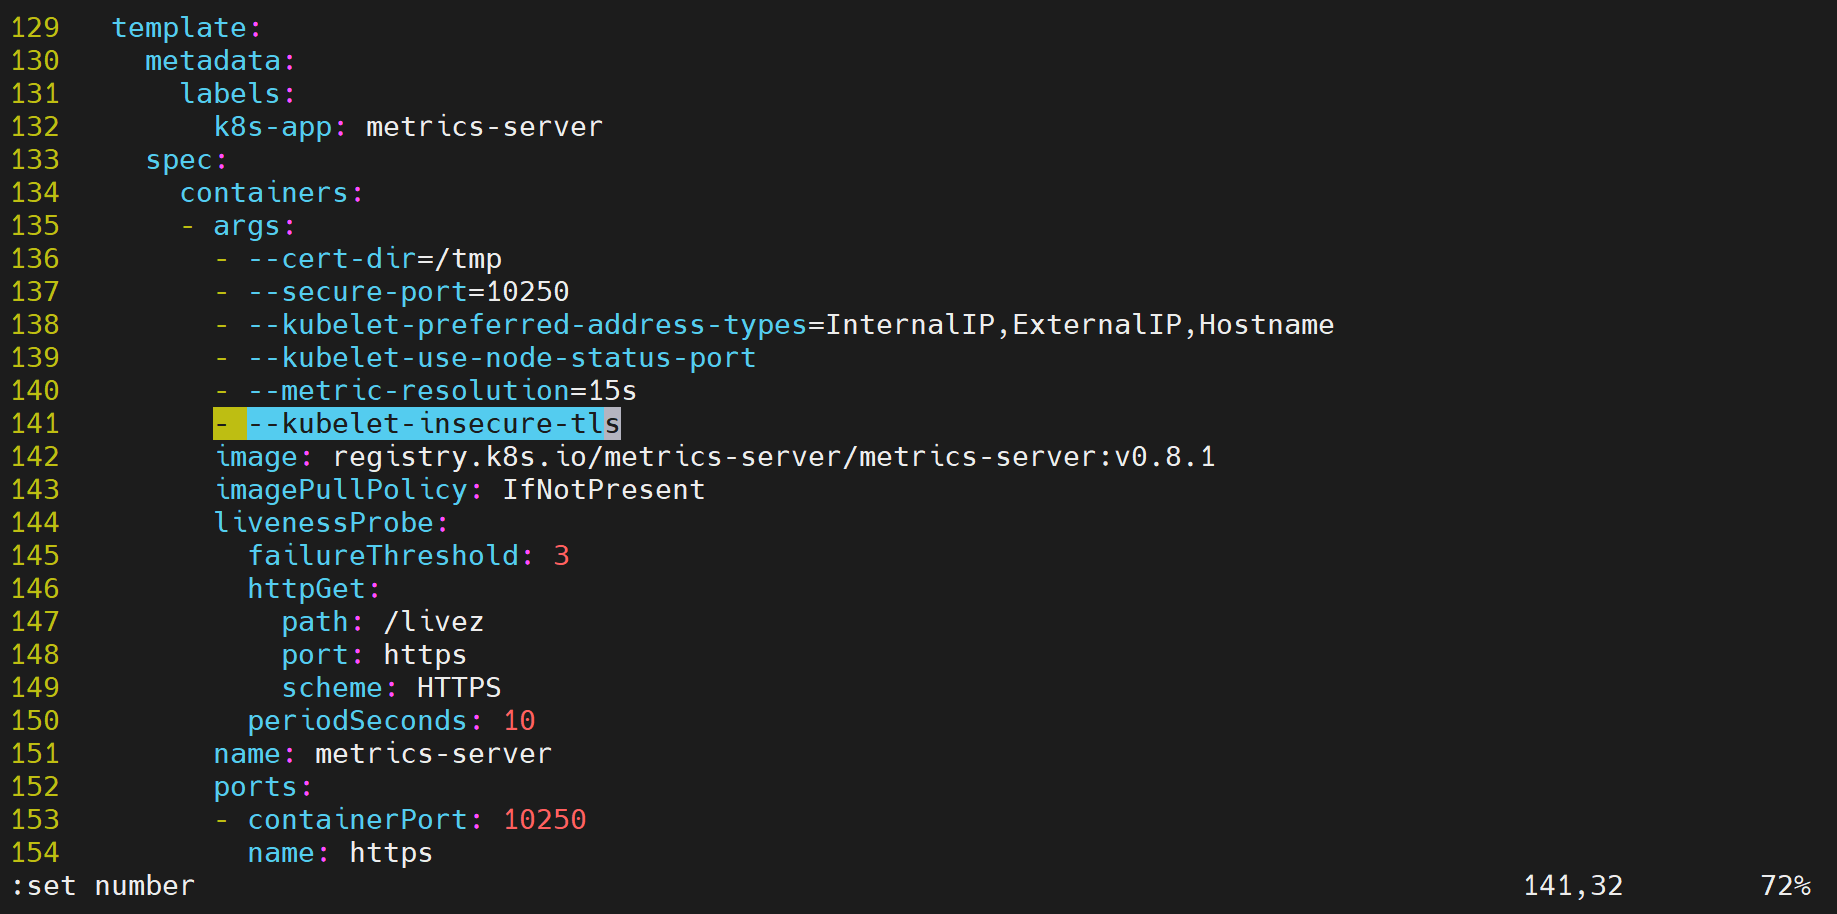
[Step3] 安装Metrics Server,需要注意的是Metrics Server依赖“metrics-server:v0.8.1”镜像,如果无法正常拉取可以访问我的百度云链接手动导入镜像。
root@k8s-master:~# kubectl create -f components.yaml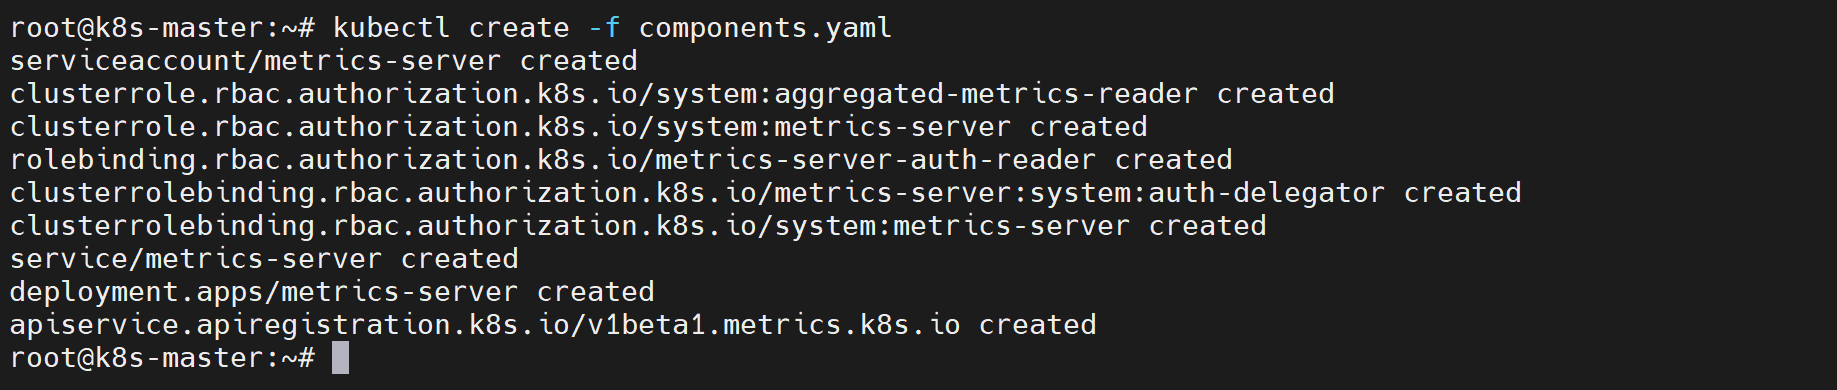
[Step4] 验证:基于文件内定义的资源清单,查询集群中该资源的运行状态与基础信息。
root@k8s-master:~# kubectl get -f components.yaml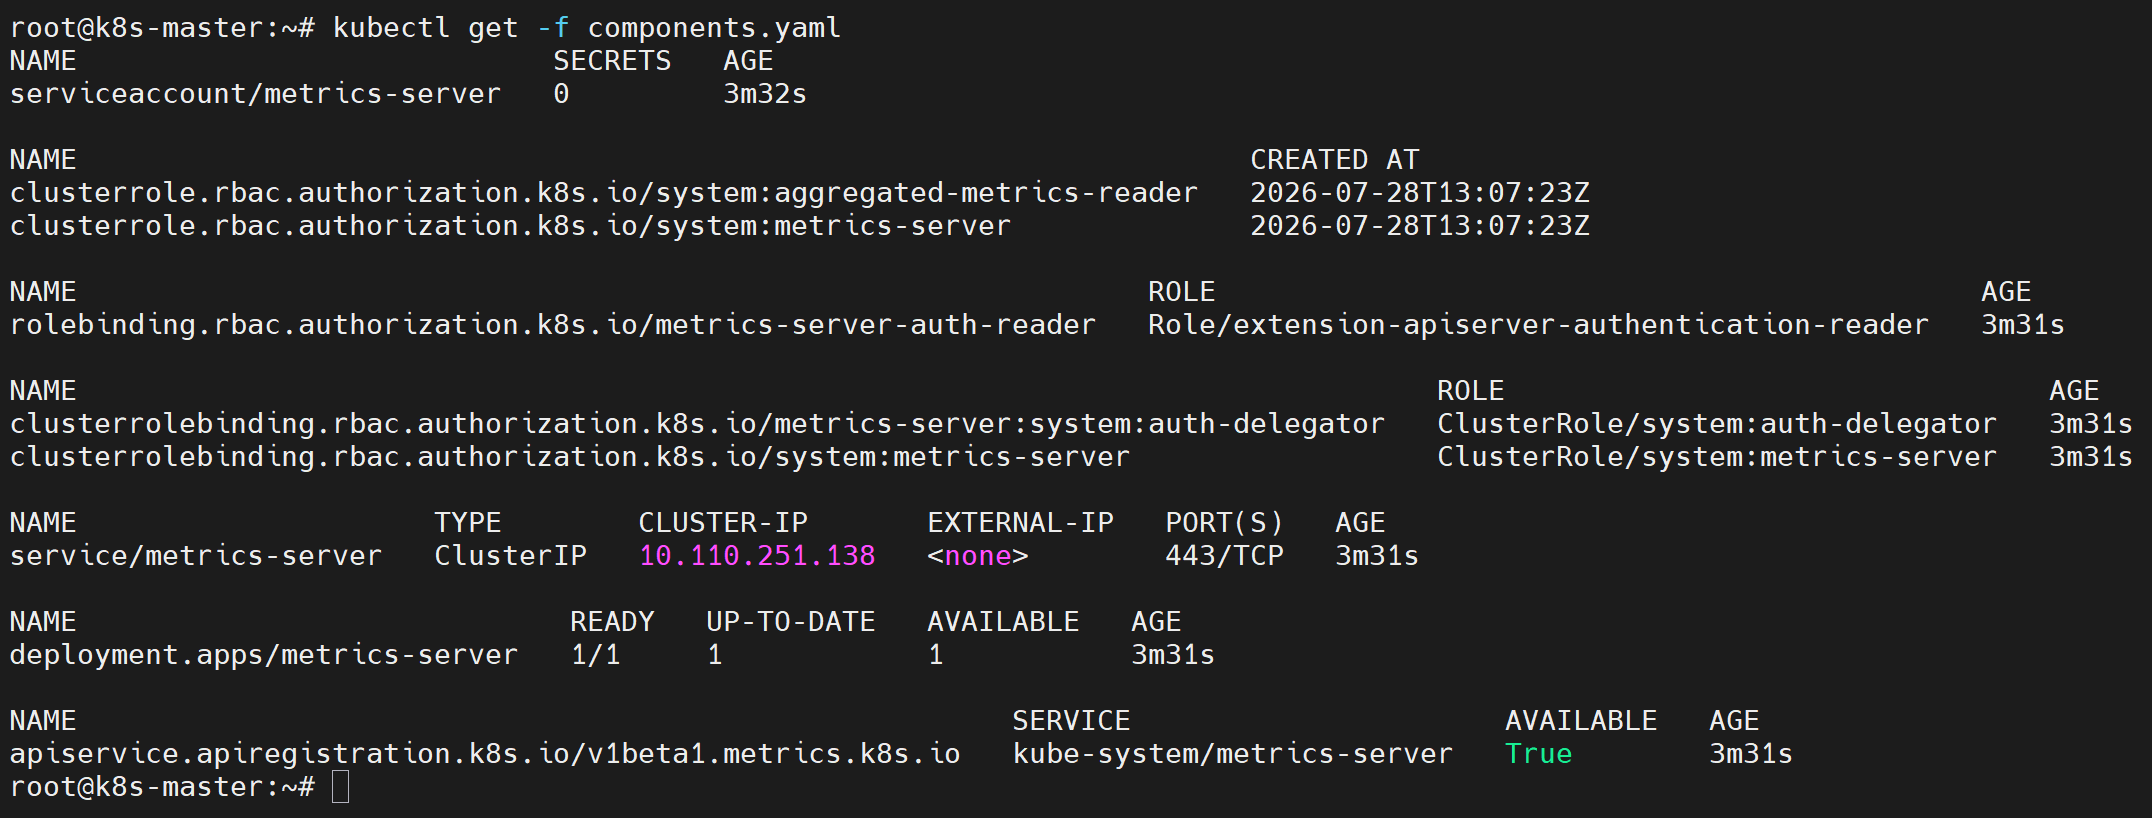
[Step5] 验证:Metrics Server默认部署在kube-system命名空间内。
root@k8s-master:~# kubectl get pod -n kube-system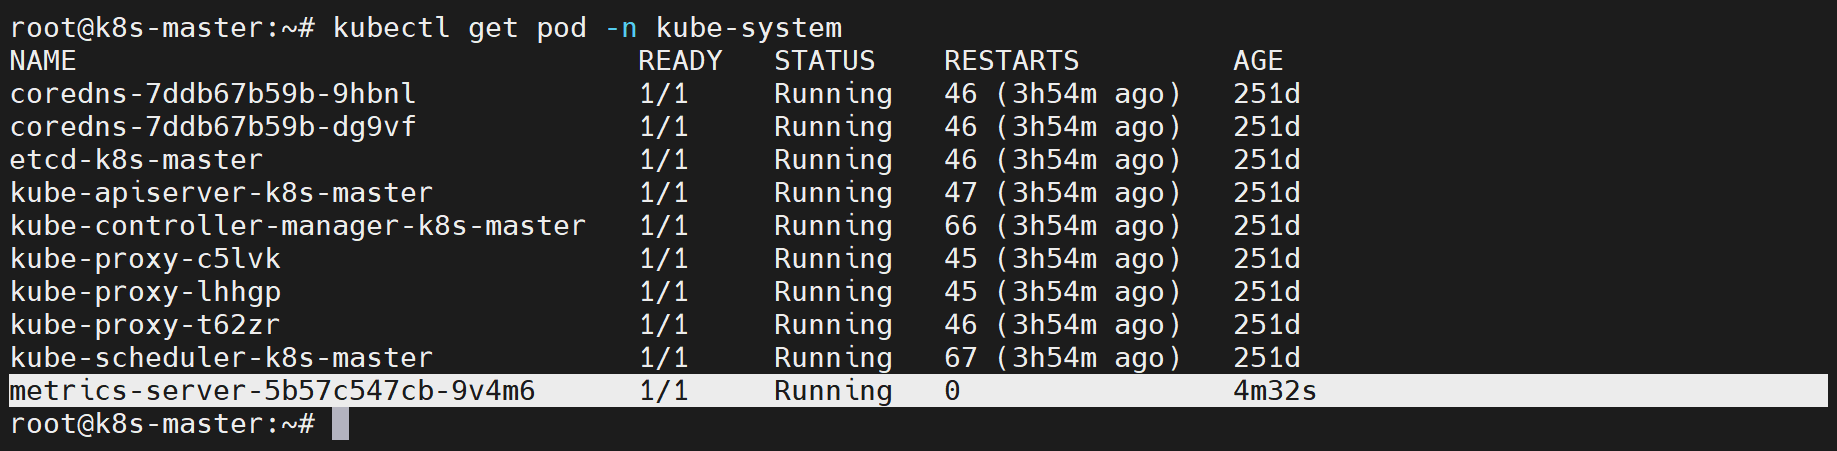
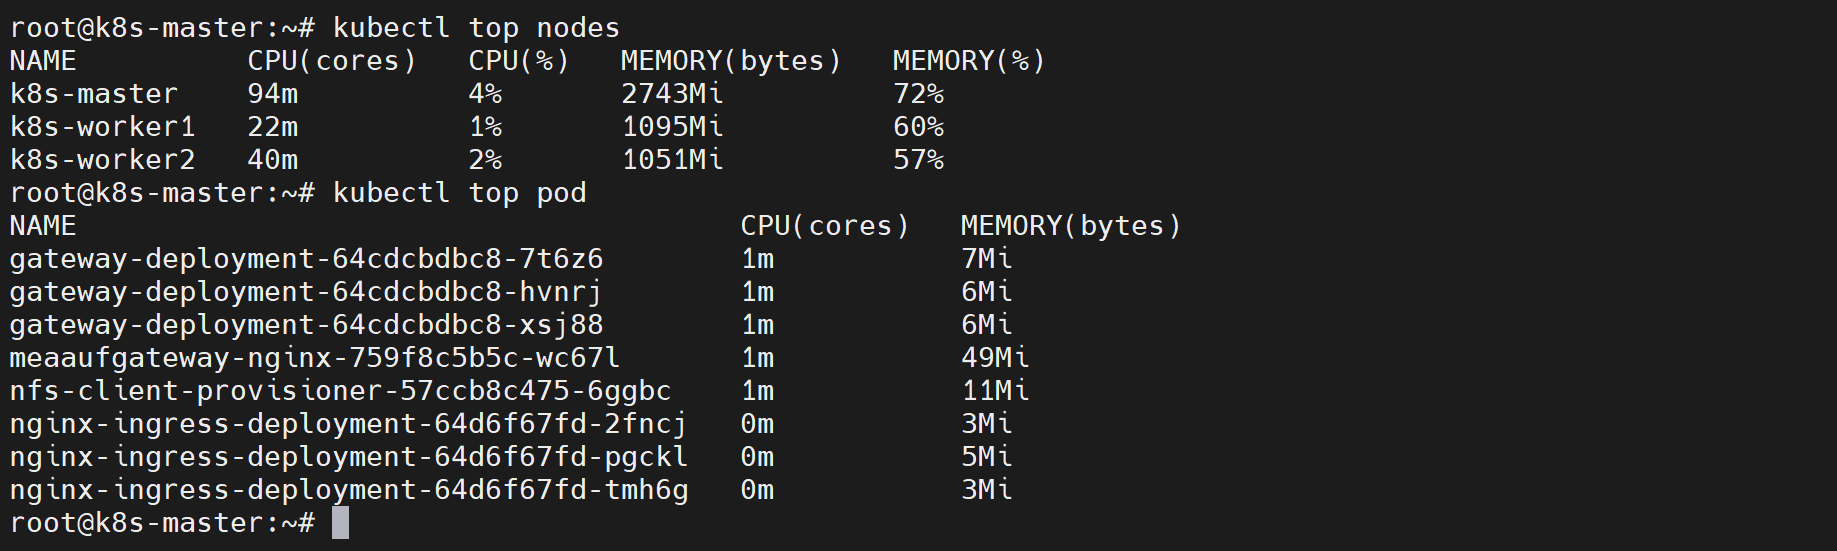
[Step6] 验证:部署完成后,能够正常查询集群节点资源使用信息。
root@k8s-master:~# kubectl top nodes
root@k8s-master:~# kubectl top pod