
一、Prometheus概述
1. Prometheus架构
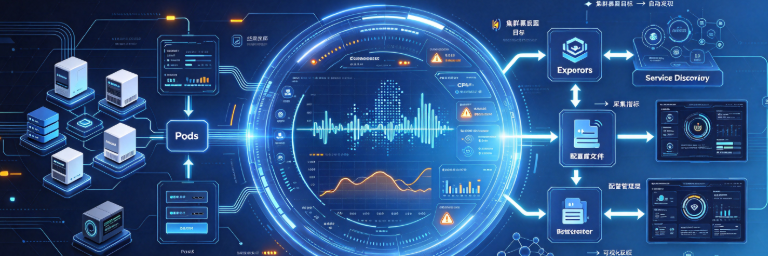
图中展示标准Prometheus监控组件架构,Prometheus采用Pull(拉取)模式采集指标,搭配周边组件实现指标采集、存储、查询、可视化、告警全链路监控,同时兼容短时任务推送指标场景,原生支持Kubernetes服务发现。架构图片来源Prometheus官网。
https://prometheus.io/assets/docs/architecture.svg
2. Prometheus核心组件
Prometheus Server:Prometheus核心服务,负责定时采集监控指标,并将时序数据持久化存储。
Exporter:指标采集代理,用于采集主机、容器、各类中间件等目标对象的运行性能指标,并对外暴露标准metrics接口供Prometheus拉取。
Grafana(可视化组件):可以与Prometheus无缝对接,通过PromQL查询时序数据,实现监控图表、大盘可视化展示。
Alertmanager:Prometheus根据预设告警规则判断并产生告警,随后将告警推送至Alertmanager。由其完成告警分组、去重、静默、路由分发等处理,推送通知至各类渠道。
Push Gateway:作为指标中转缓存组件,专门用于承载一次性、短时运行任务(Short-lived-jobs)推送的监控指标,弥补Prometheus拉取模式无法采集短时任务数据的短板。
3. Prometheus Metrics
Prometheus采集的监控指标按照来源可以分为三大类:宿主机指标、Kubernetes组件指标、Kubernetes核心资源指标。
3.1 宿主机监控指标
由Node Exporter工具负责采集,在生产环境中通常以DaemonSet方式部署在集群的每一个节点上。它能够采集宿主机集成运行指标,包含系统负载(Load)、CPU使用率、内存占用、磁盘读写、磁盘空间、网卡网络流量等操作系统基础资源信息。
3.2 Kubernetes组件监控数据
指集群控制平面与节点组件暴露的指标,涵盖API Server、Scheduler、Controller Manager、kubelet、etcd等核心组件的运行指标,用于监控集群管理组件的监控状态、请求吞吐量、延迟、错误等运行参数。
3.3 Kubernetes核心资源指标(Core Metrics)
这类指标描述集群内各类资源对象运行状态,包括Pod、Node、容器、Service、Deployment等Kubernetes核心资源的监控数据,典型指标为容器CPU、内存资源消耗量、也是kubectl top水平扩缩容功能依赖的基础数据源。
4. Prometheus工作流程
Prometheus Server按照预设周期,主动从配置的任务(jobs)、Exporter拉取监控指标;同时也可以接收由Pushgateway转发而来的指标数据。
Prometheus Server将采集到的时序指标持久化存储至本地,并且持续执行预先定义的告警规则与记录规则,生成新的时序数据。当满足告警条件时,将告警信息推送至Alertmanager。
Alertmanager依据配置策略,对收到的告警进行分组、去重、静默、路由分发处理,最终向各类通知渠道发送告警消息。
用户可通过Grafana或Prometheus自带界面,借助PromQL查询时序数据,实现监控指标可视化展示。
二、Prometheus部署
如果无法正常拉取镜像,可以访问我提供的百度云链接下载。
Prometheus组件包: https://pan.baidu.com/s/1zWdBIoPRMvIexApmj1ToGQ?pwd=f4f2
提取码: f4f2
1. 安装Prometheus
[Step1] Prometheus Operator采用声明式部署模式,能够简化Prometheus、Alertmanager、Grafana等组件的部署与运维管理。实验通过从GitHub仓库克隆代码进行部署,本次选用版本为v0.16.0。不同版本的Kubernetes集群对Prometheus组件存在兼容性要求,可以根据集群版本,选择适配的Prometheus部署版本。
root@k8s-master:~# wget https://gh-proxy.org/https://github.com/prometheus-operator/kube-prometheus/archive/refs/tags/v0.16.0.tar.gz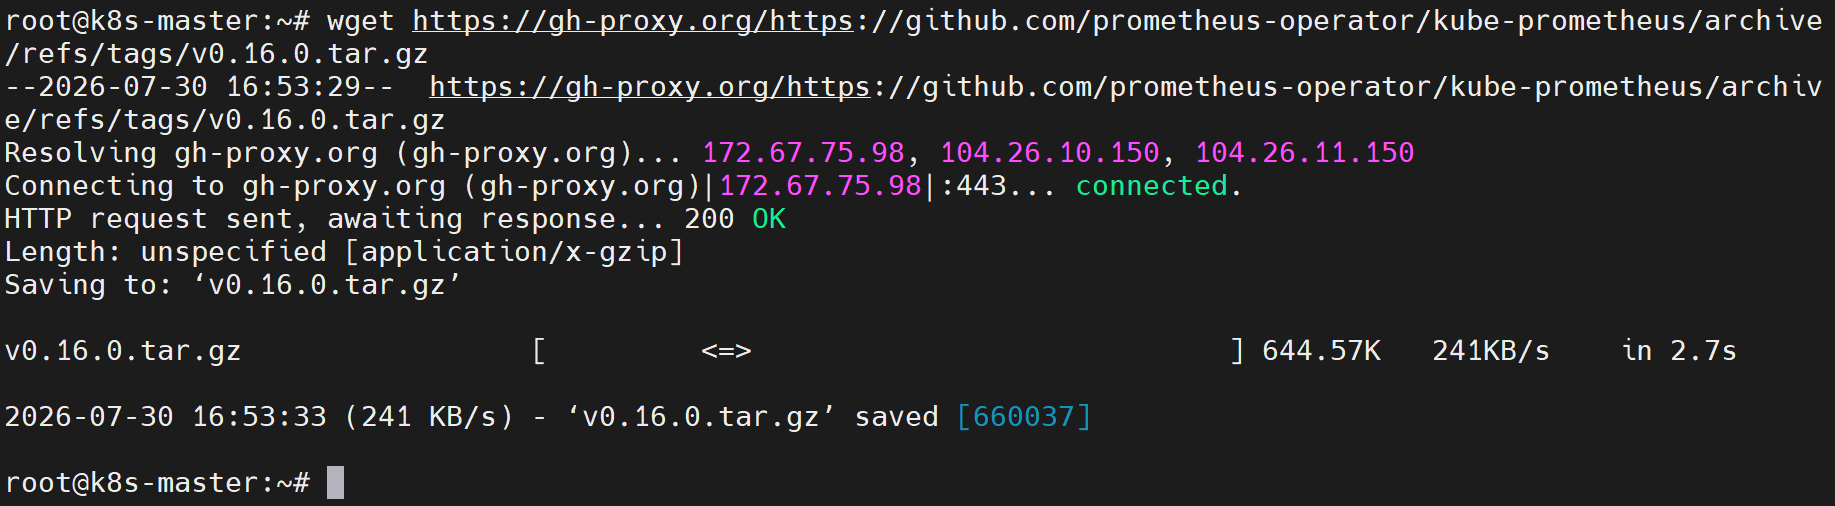
[Step2] 将压缩包解压,进入解压目录。批量加载manifests/setup目录下所有资源清单,创建Prometheus Operator所需的CRD自定义资源定义。CRD是Prometheus Operator的前置依赖,必须优先部署,后续才能正常创建Prometheus、ServiceMonitor等自定义监控资源。
root@k8s-master:~# tar xf v0.16.0.tar.gz
root@k8s-master:~# cd kube-prometheus-0.16.0/
root@k8s-master:~/kube-prometheus-0.16.0# kubectl create -f manifests/setup/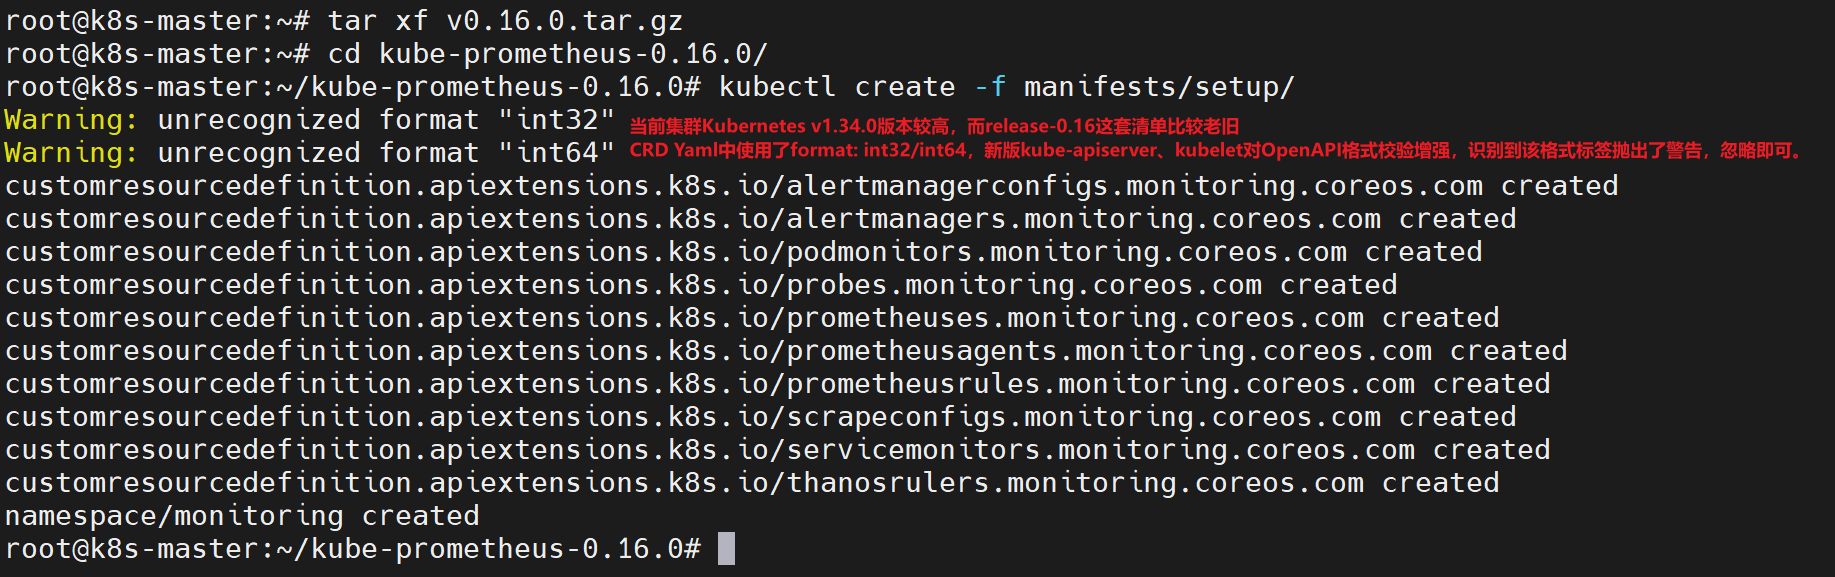
[Step3] Prometheus Operator依赖CRD,而CRD从创建到Established就绪需要一段时间。如果不等待就绪,立即部署后面的Prometheus资源,会出现找不到资源类型的报错。执行下列命令等待集群内所有CRD资源变为Established就绪状态,避免因CRD未就绪引发资源创建失败。
root@k8s-master:~# kubectl wait --for condition=Established --all CustomResourceDefinition --namespace=monitoring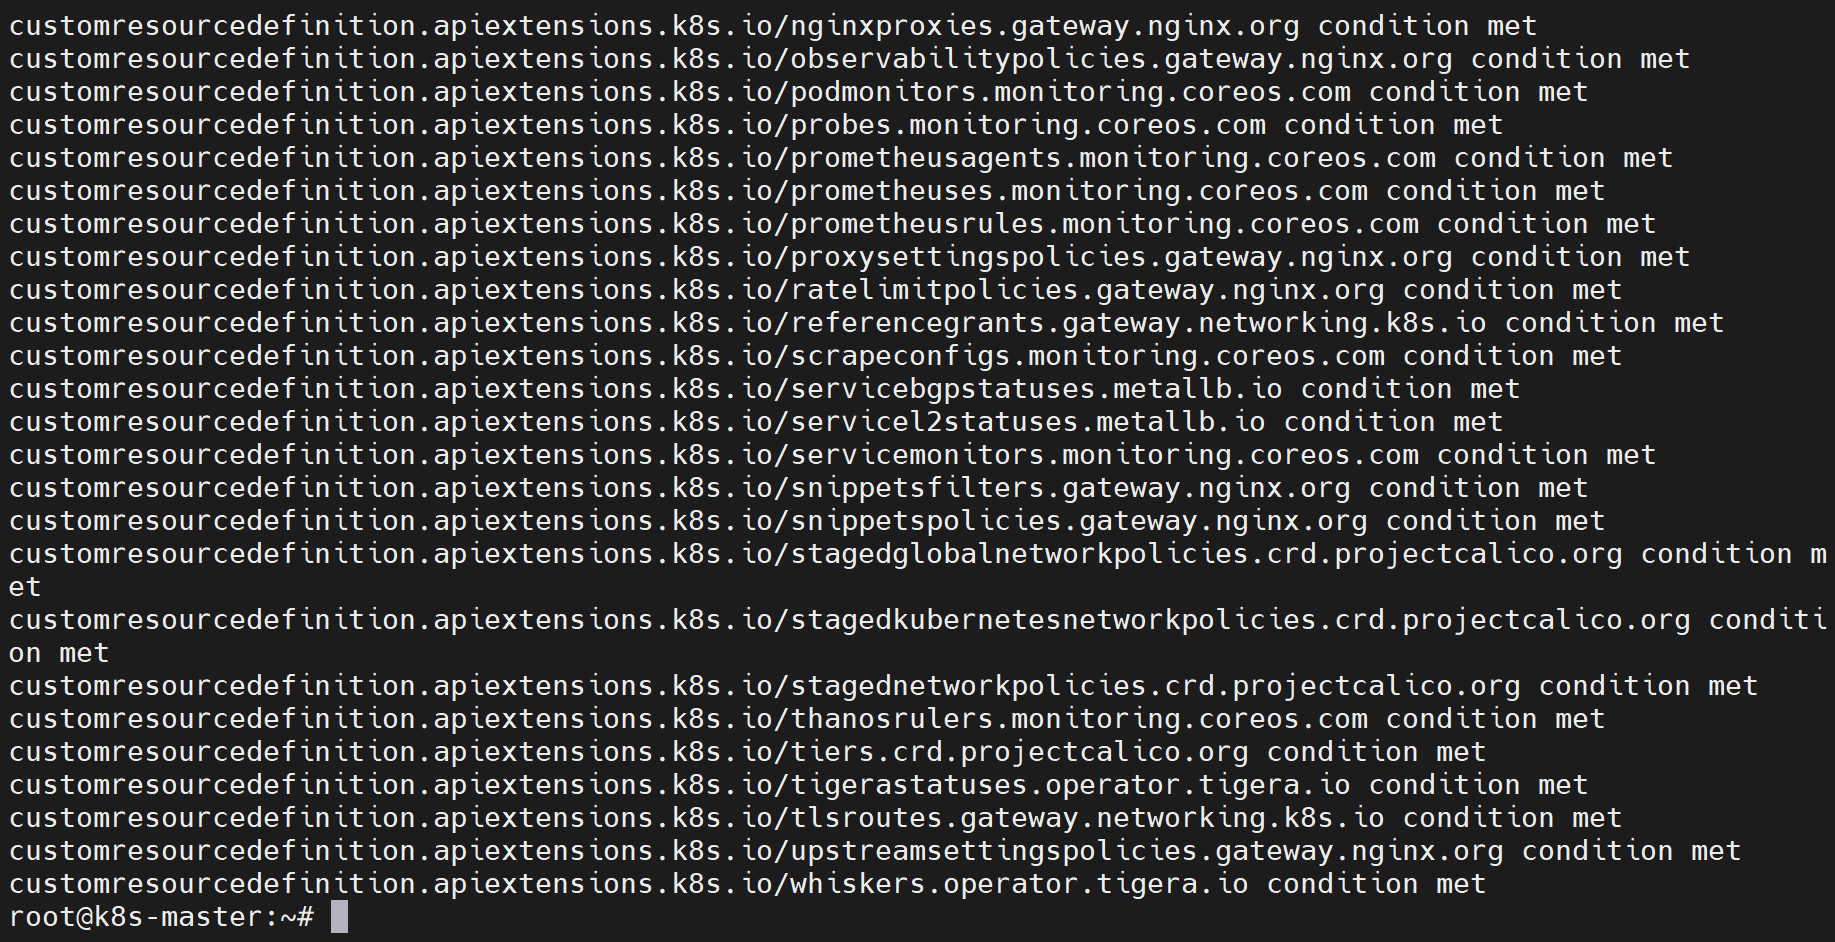
[Step4] Prometheus依赖于以下几个镜像,可以自行下载或使用我百度云提供的镜像包手动导入。
alertmanager:v0.28.1、blackbox-exporter:v0.27.0、configmap-reload:v0.15.0、grafana:12.1.0、kube-state-metrics:v3.2.6、node-exporter:v1.9.1、prometheus-adapter:v0.12.0、prometheus-operator:v0.85.0、kube-rbac-proxy:v0.19.1、prometheus:v3.5.0[Step5] 验证:导入完成后可以执行我下列的命令,查看是否导入成功。
root@k8s-worker1:~# crictl images | grep -E "node-exporter|kube-rbac-proxy|blackbox-exporter|alertmanager|configmap-reload|grafana|kube-state-metrics|prometheus"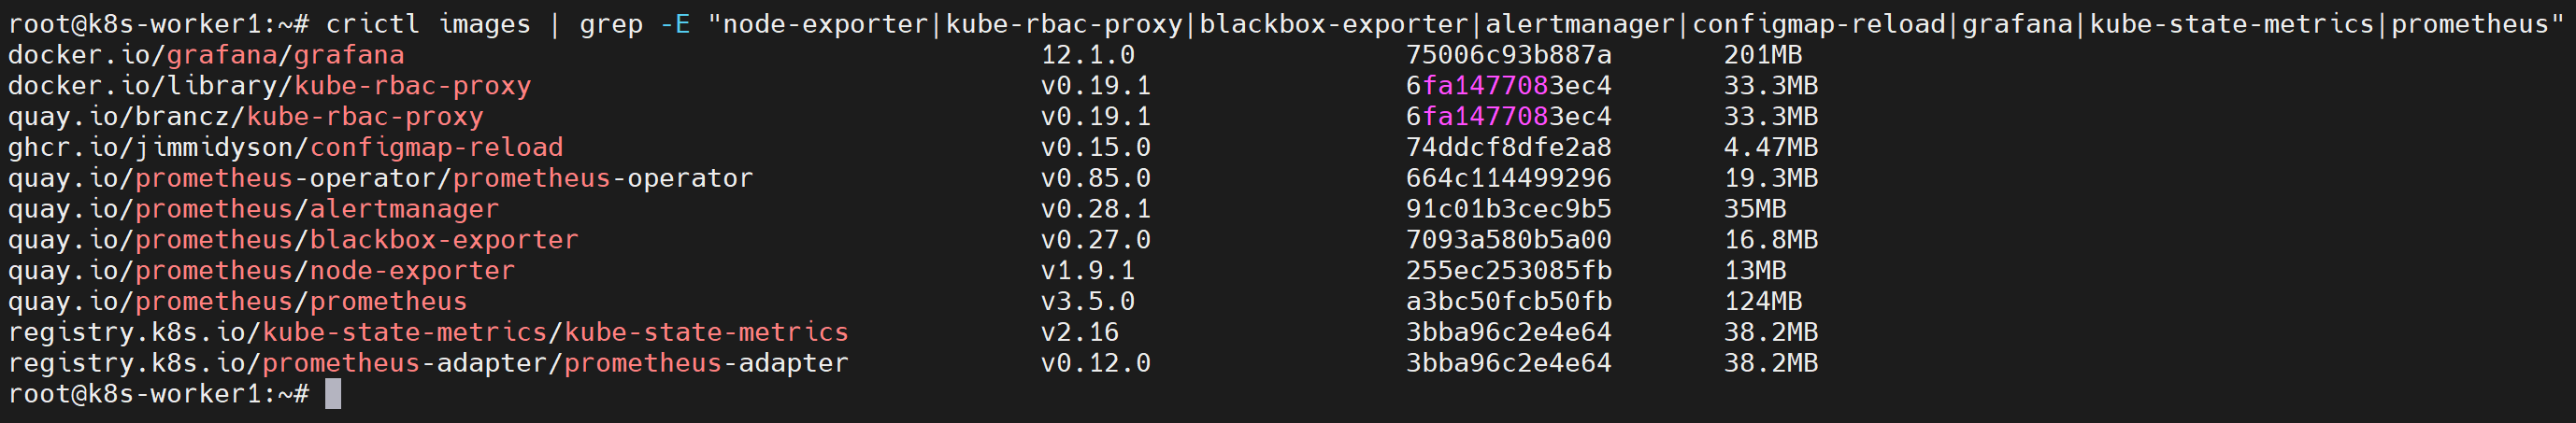
[Step6] 默认情况下Grafana被网络策略隔离,需要手动开放端口供外部访问,这里将Grafana策略删除。
root@k8s-master:~/kube-prometheus-0.16.0# rm -rf manifests/grafana-networkPolicy.yaml[Step7] 本次Kubernetes集群部署于虚拟机环境,所有虚拟机采用最小化安装。若要通过浏览器访问Grafana,需要服务绑定外部访问地址。实验将Grafana Service修改为LoadBalancer类型,依托MetalLB组件为服务分配External-IP,实现外部访问。如果集群中的主机安装桌面,可以将Grafana Service修改为NodePort类型,并指定nodePort。
root@k8s-master:~/kube-prometheus-0.16.0# vim manifests/grafana-service.yaml
# 分别添加下列内容
spec:
type: LoadBalancer # 新增内容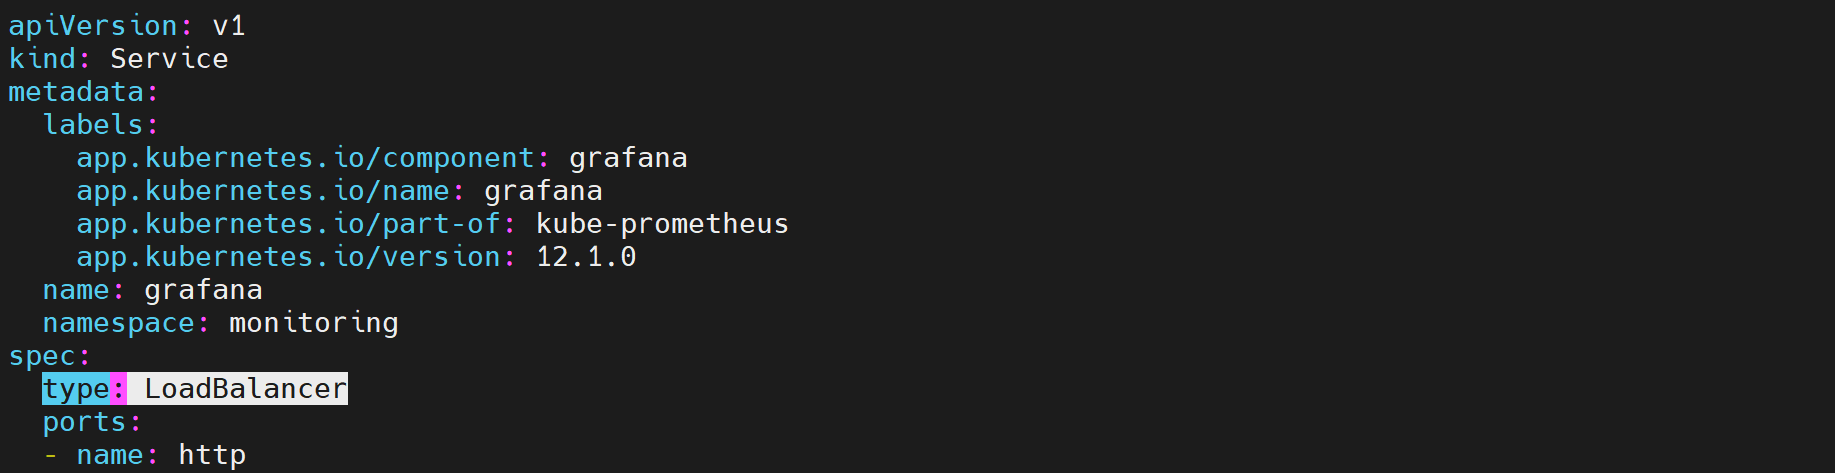
[Step8] 由于这里我们使用的是本地镜像,因此要下列文件中分别添加imagePullPolicy策略。
root@k8s-master:~# cd kube-prometheus-0.16.0/manifests/
root@k8s-master:~/kube-prometheus-0.16.0/manifests# vim nodeExporter-daemonset.yaml
root@k8s-master:~/kube-prometheus-0.16.0/manifests# vim blackboxExporter-deployment.yaml
root@k8s-master:~/kube-prometheus-0.16.0/manifests# vim grafana-deployment.yaml
root@k8s-master:~/kube-prometheus-0.16.0/manifests# vim kubeStateMetrics-deployment.yaml
root@k8s-master:~/kube-prometheus-0.16.0/manifests# vim prometheusAdapter-deployment.yaml
root@k8s-master:~/kube-prometheus-0.16.0/manifests# vim prometheusOperator-deployment.yaml
root@k8s-master:~/kube-prometheus-0.16.0/manifests# vim alertmanager-alertmanager.yaml
root@k8s-master:~/kube-prometheus-0.16.0/manifests# vim prometheus-prometheus.yaml
# 分别在image下面添加一行
imagePullPolicy: IfNotPresent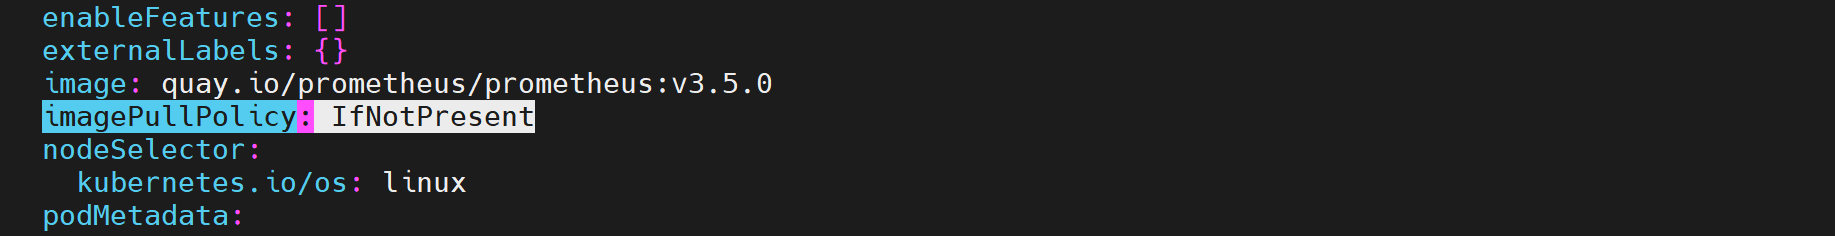
[Step9] 根据目录内YAML文件向Kubernetes集群声明式地批量创建资源。
root@k8s-master:~# cd kube-prometheus-0.16.0/
root@k8s-master:~/kube-prometheus-0.16.0# kubectl create -f manifests/
[Step10] 验证:查询monitoring命名空间下名称为grafana的Service资源详细信息,可以看到我们定义的端口号30303。
root@k8s-master:~# kubectl get -n monitoring service/grafana
[Step11] 验证:在浏览器中访问Grafana。
http://EXTERNAL-IP:3000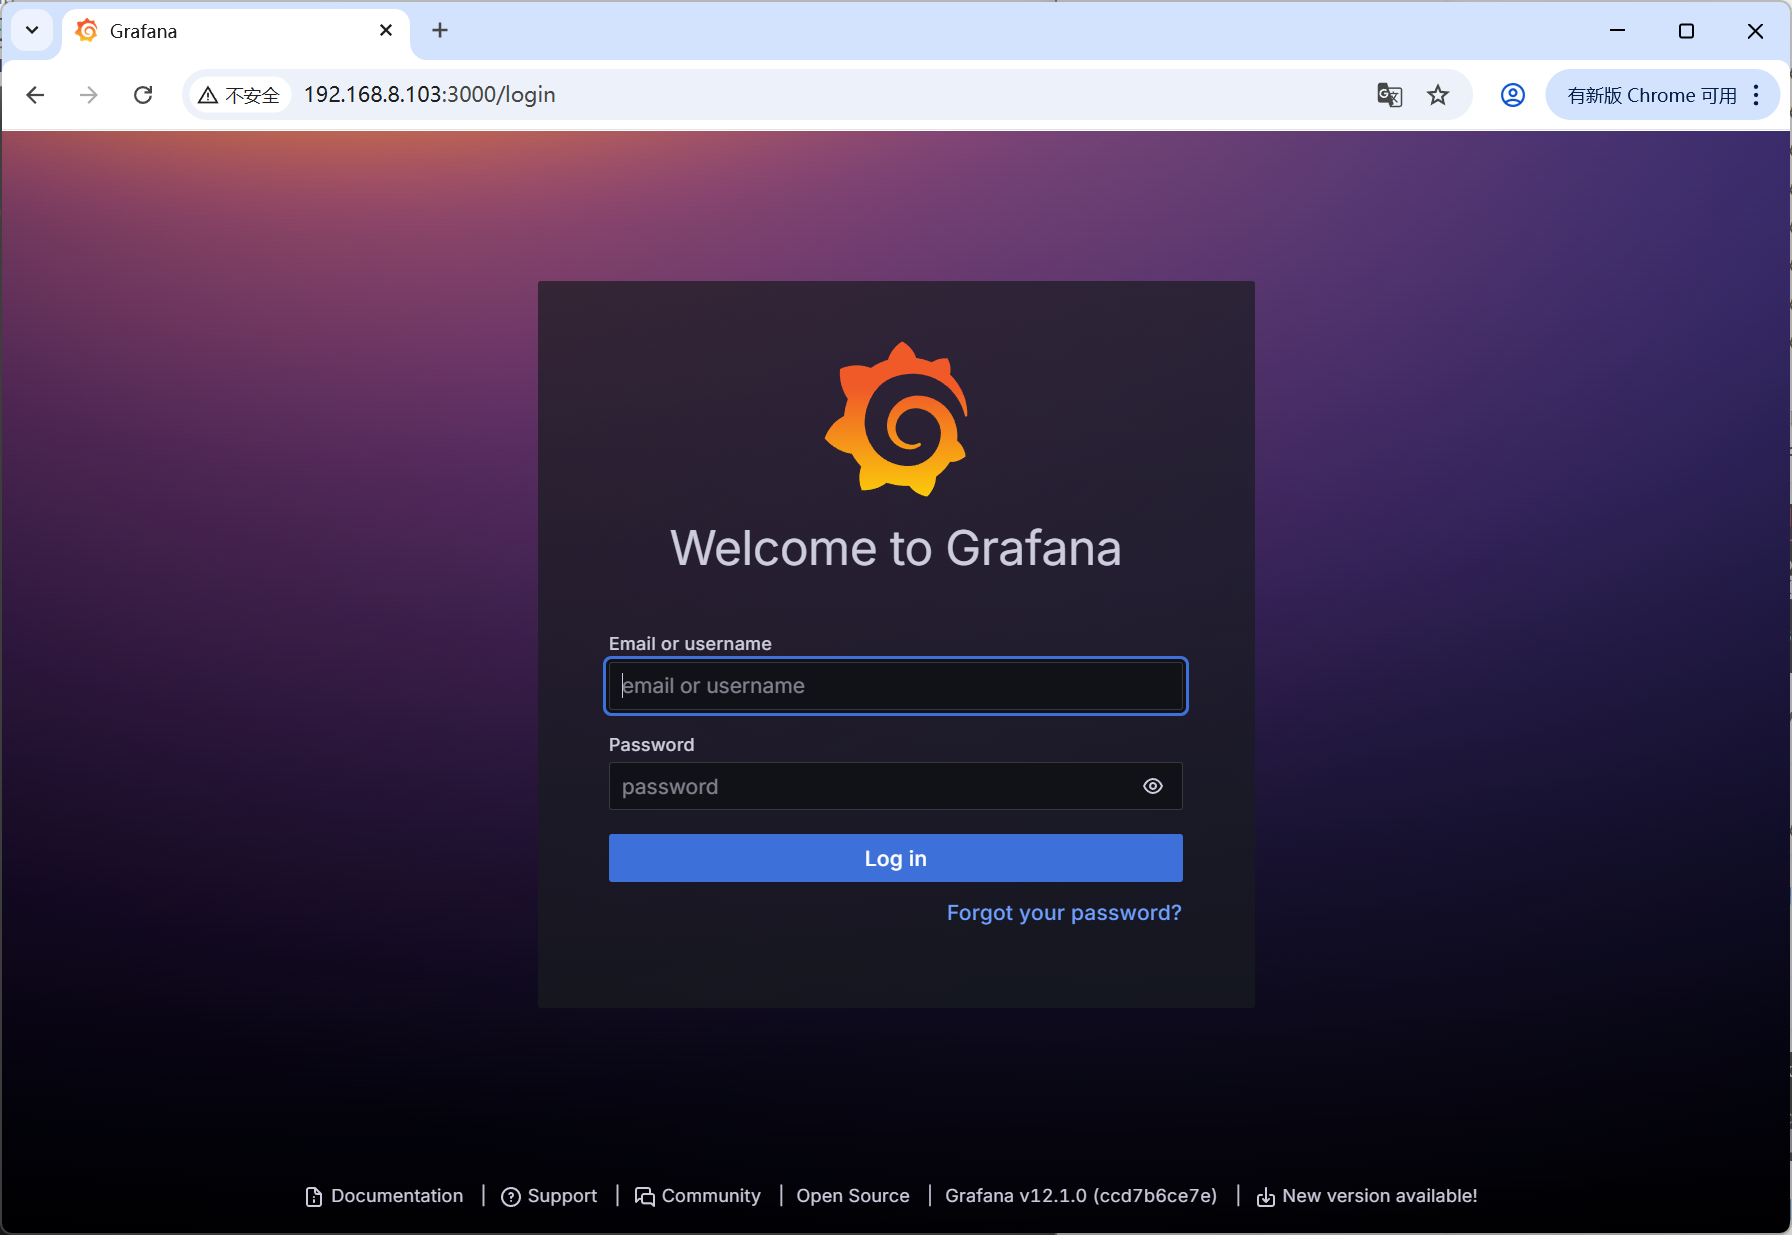
[Step12] 验证:输入账号和密码登录Grafana,此时会提示你更新密码,可以选择更新或跳过“Skip”。
账号:admin
密码:admin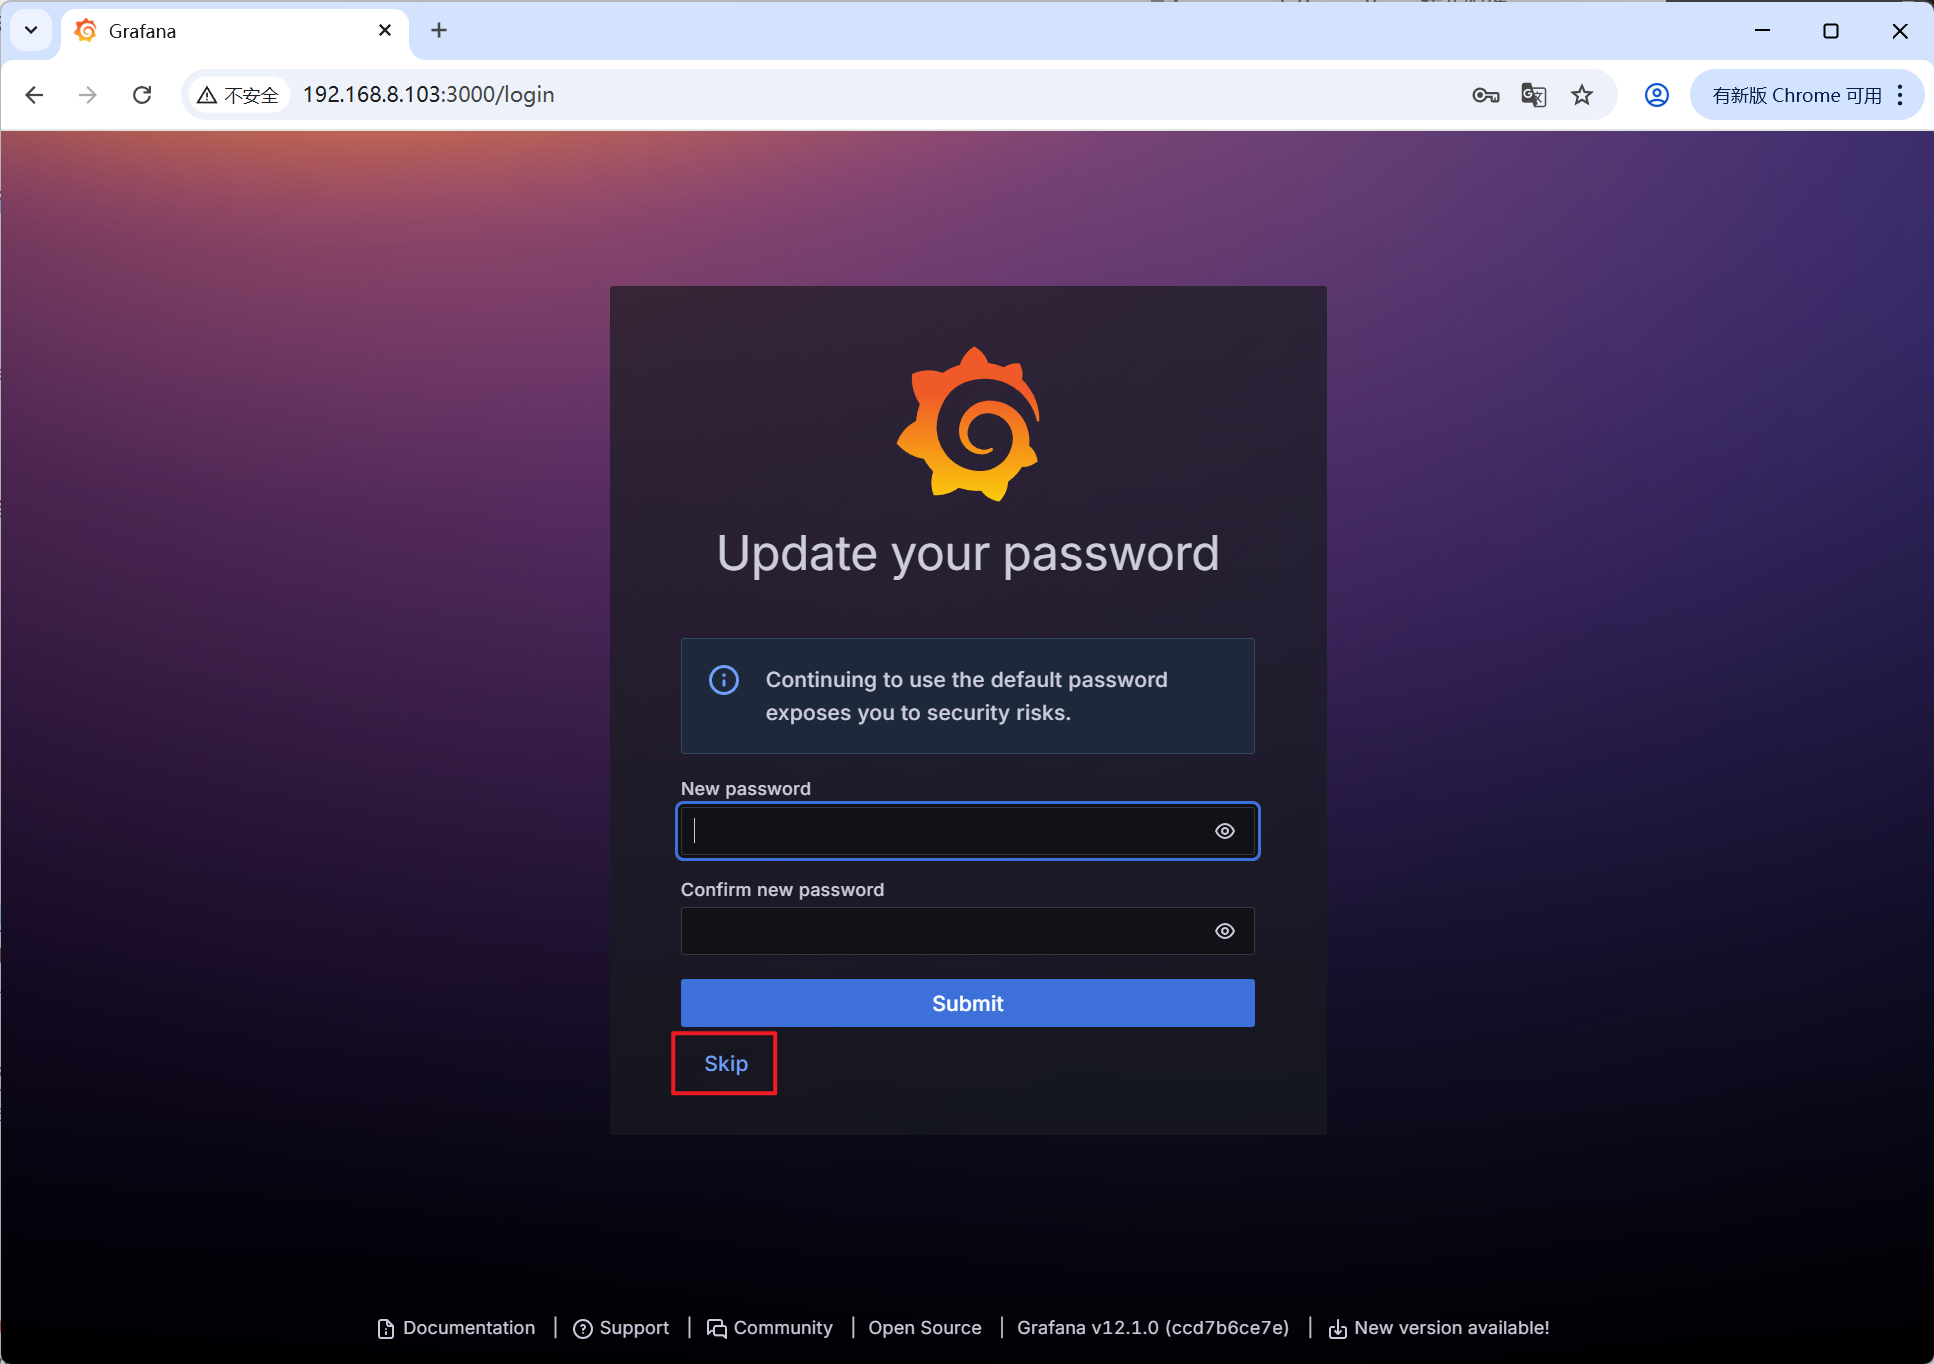
2. 设置为简体中文
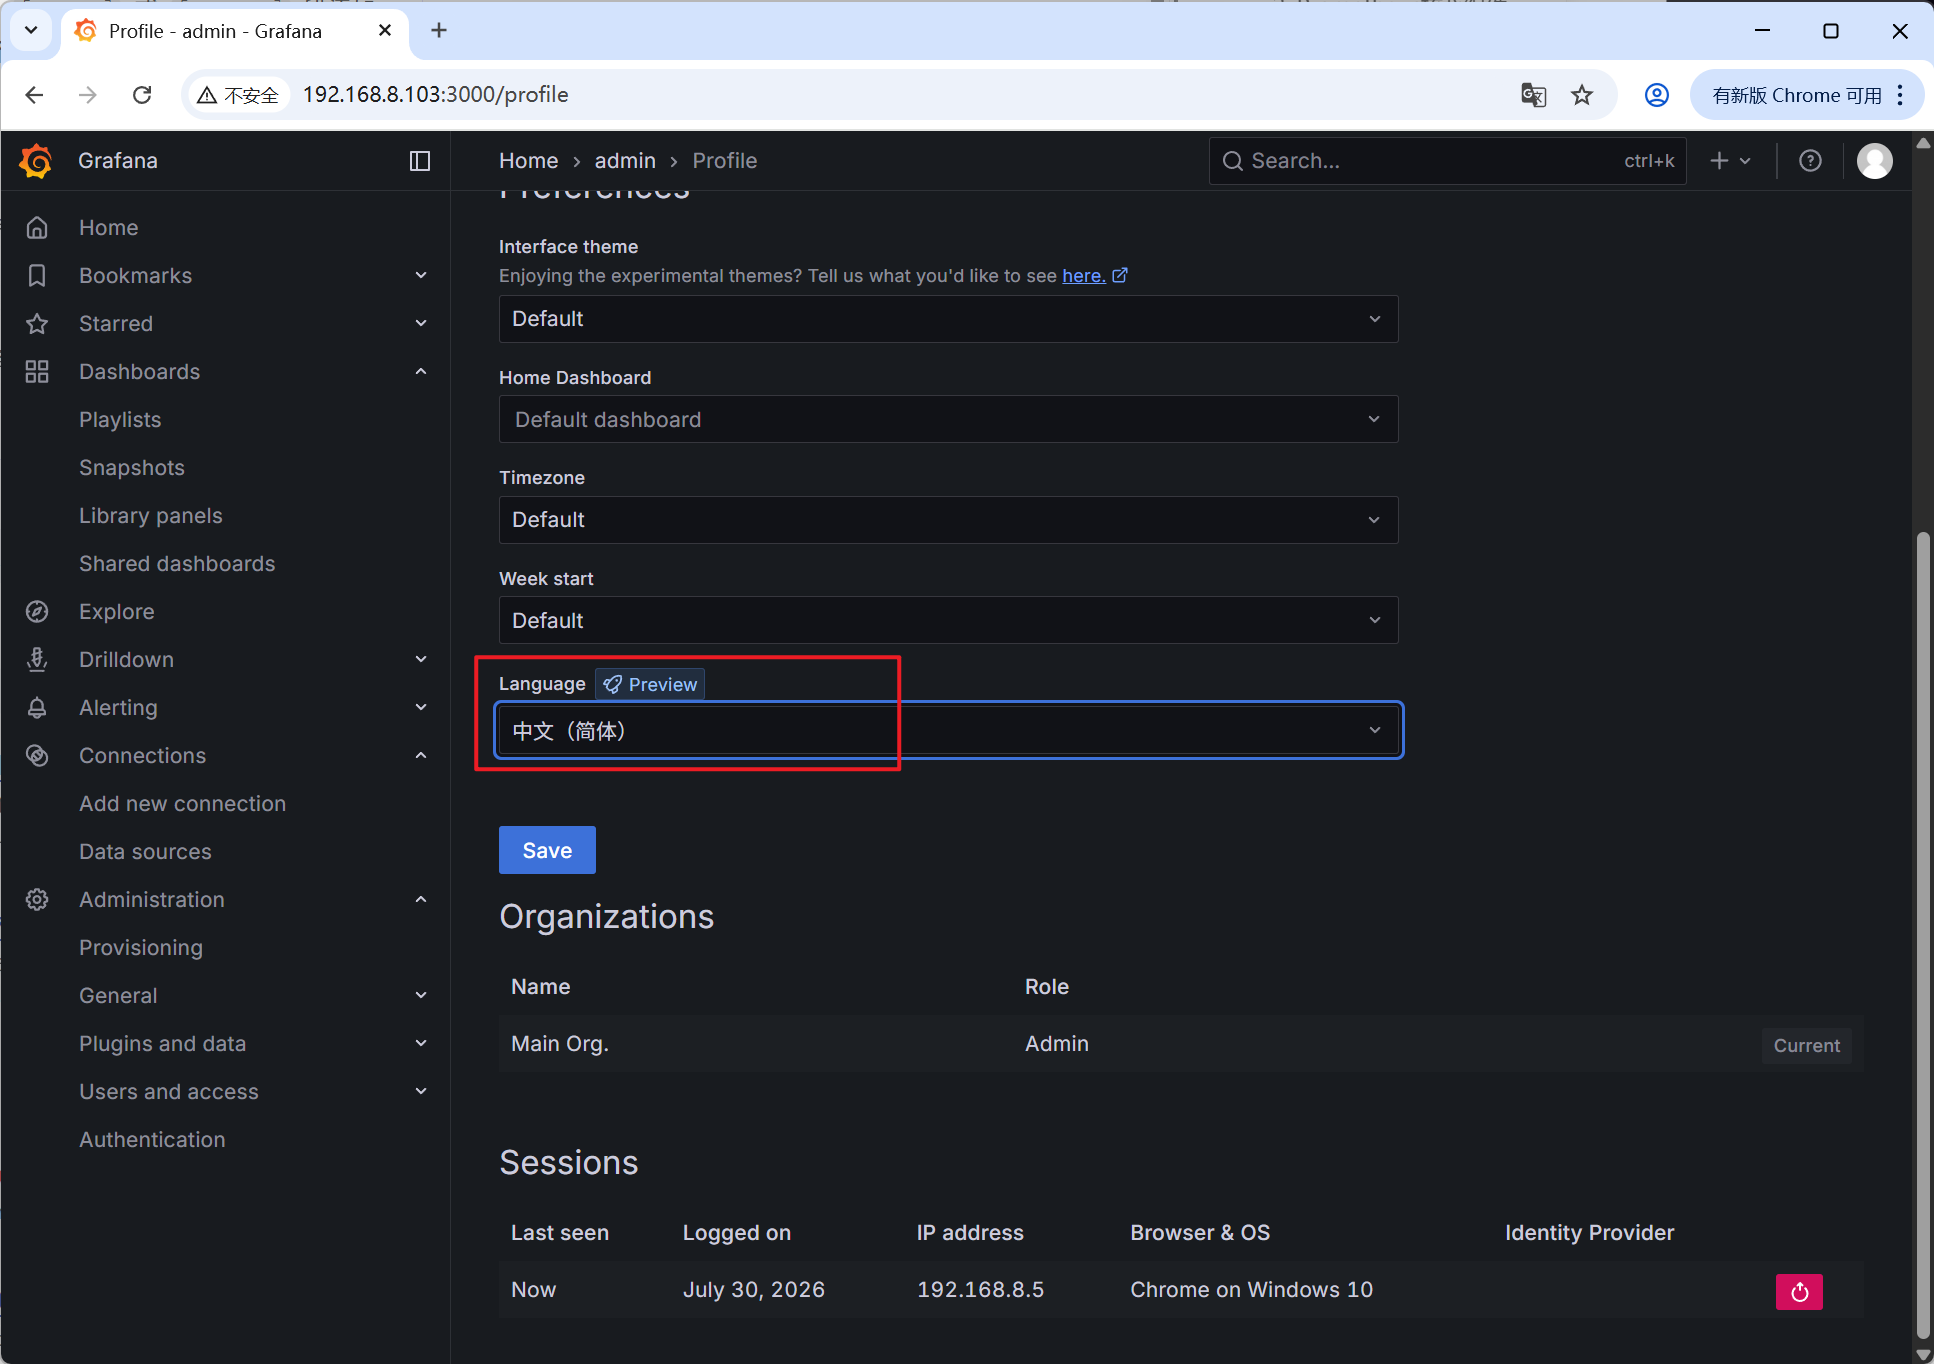
[Step1] 点击右上角头像,选择Profile。
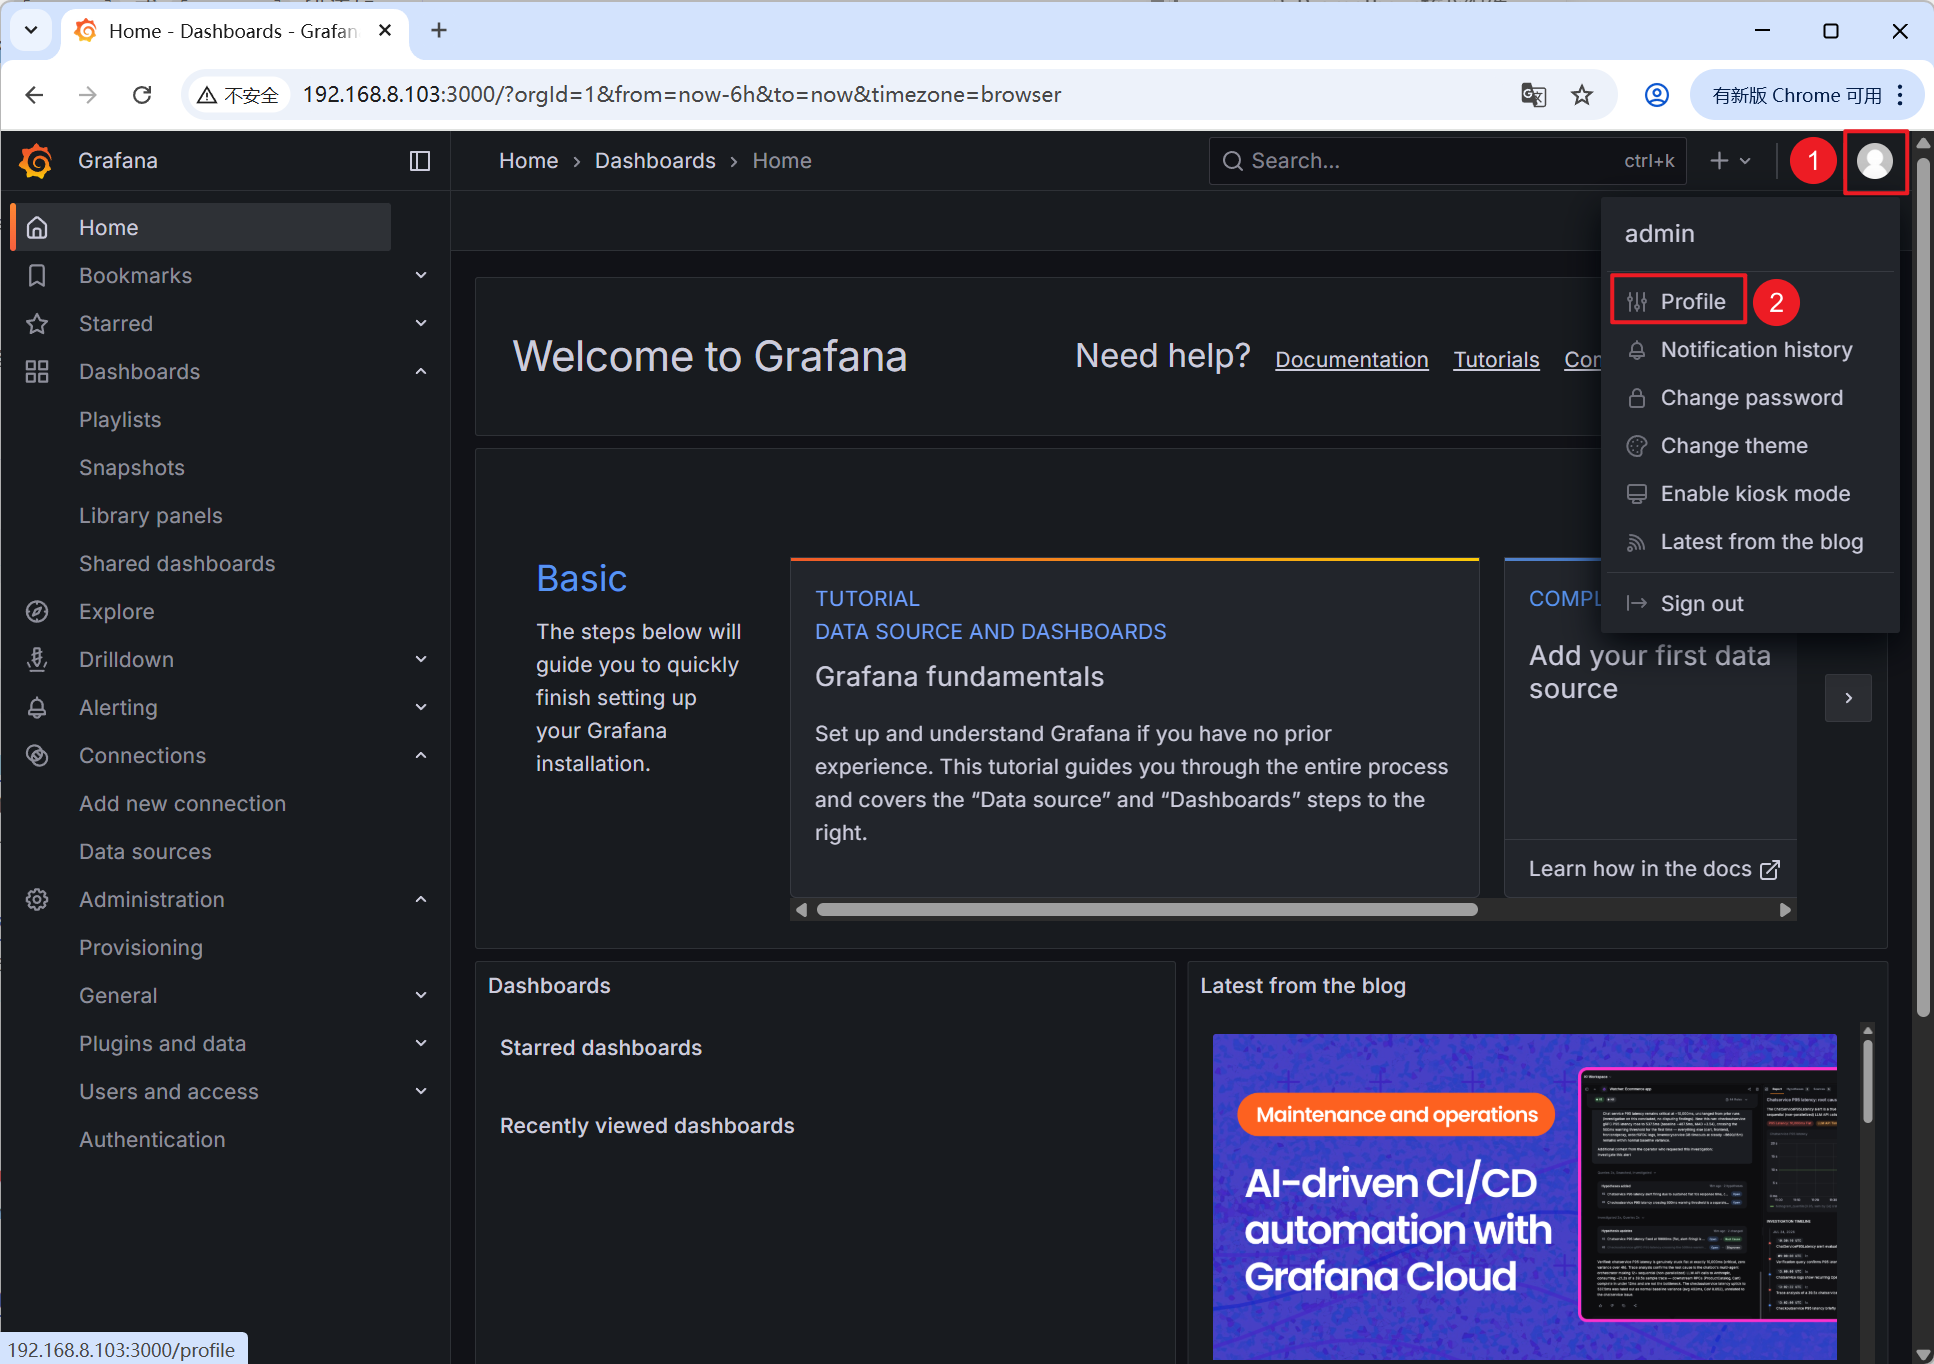
[Step2] 找到Language,选择简体中文,然后点击“Save”。
3. 安装模板
[Step1] 访问Grafana模版网站,注册并登录账号,然后在左侧下拉框中进行筛选。“Filters”中选择“Kubernetes”,“Category”中选择“Docker”。
https://grafana.com/grafana/dashboards/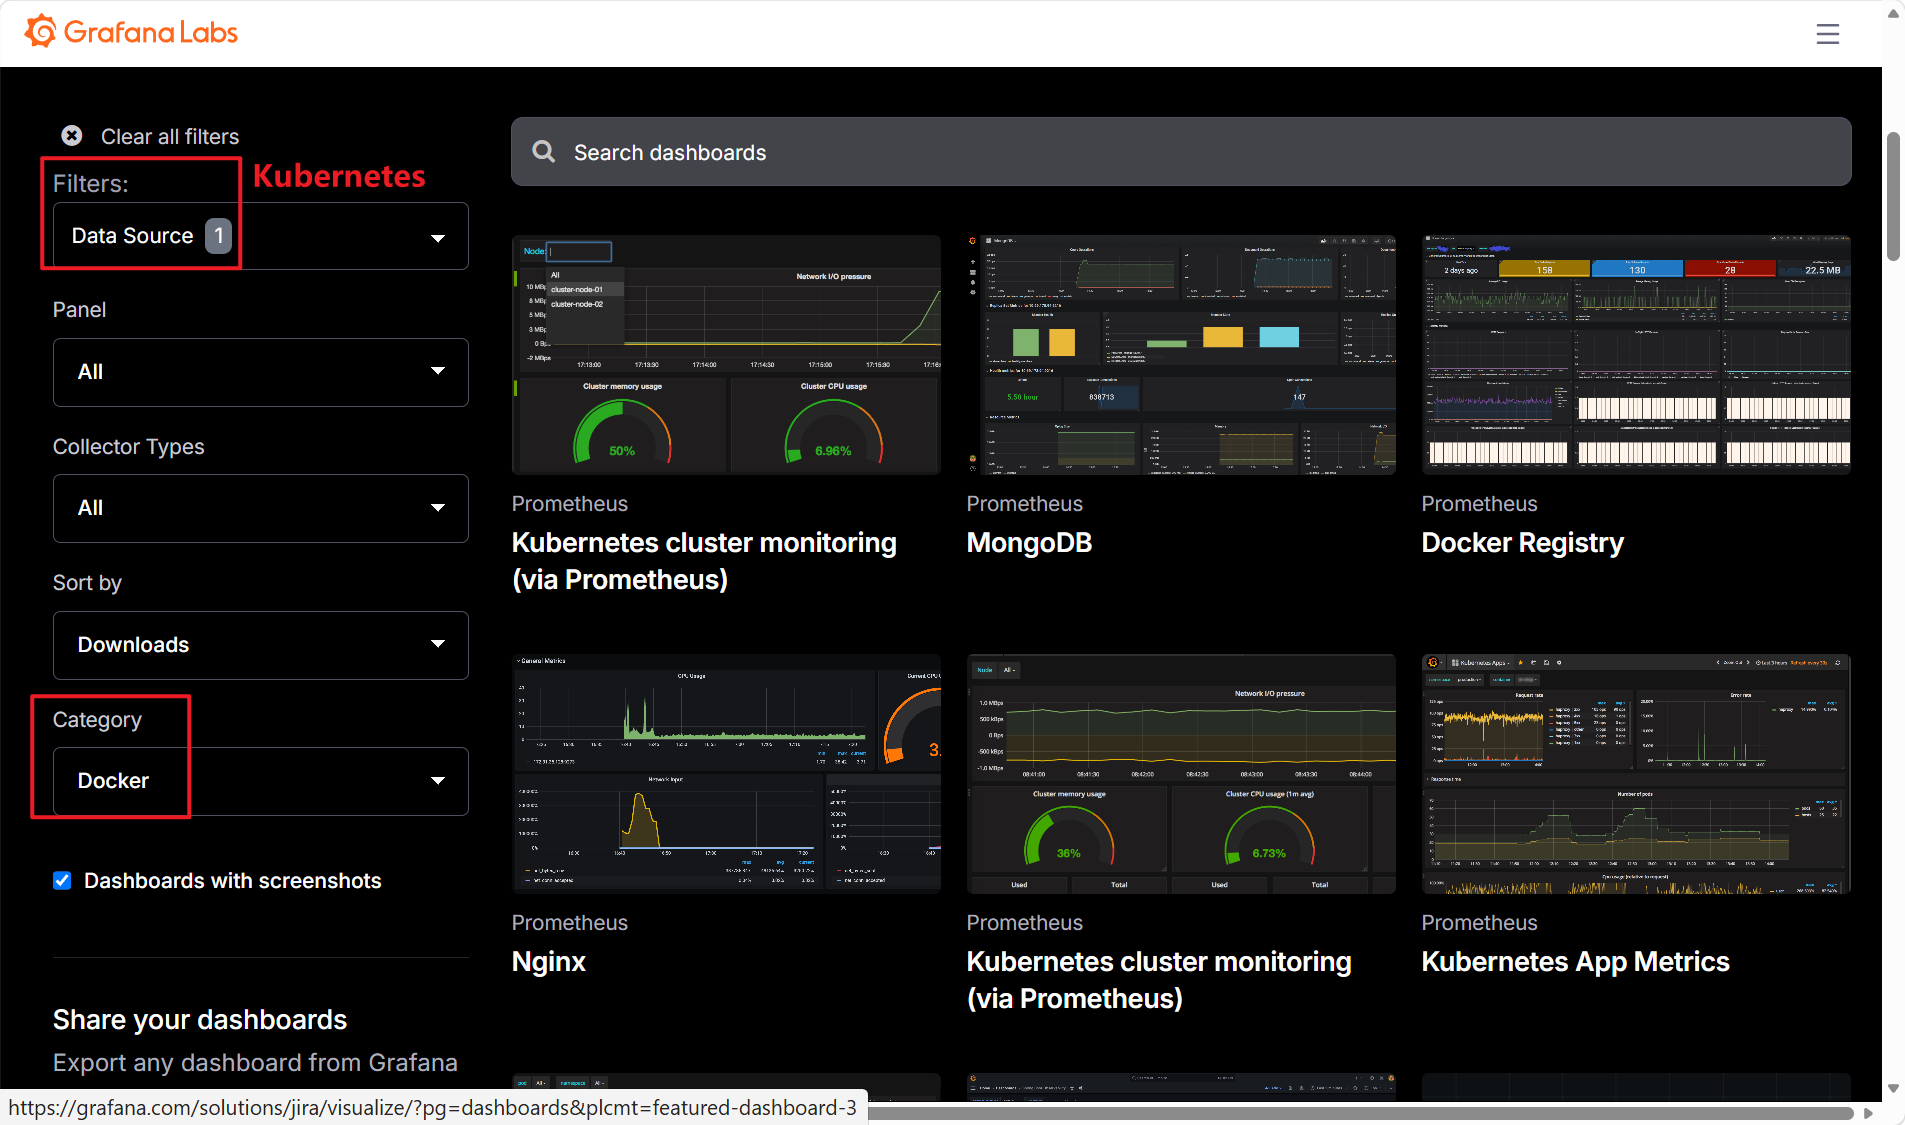
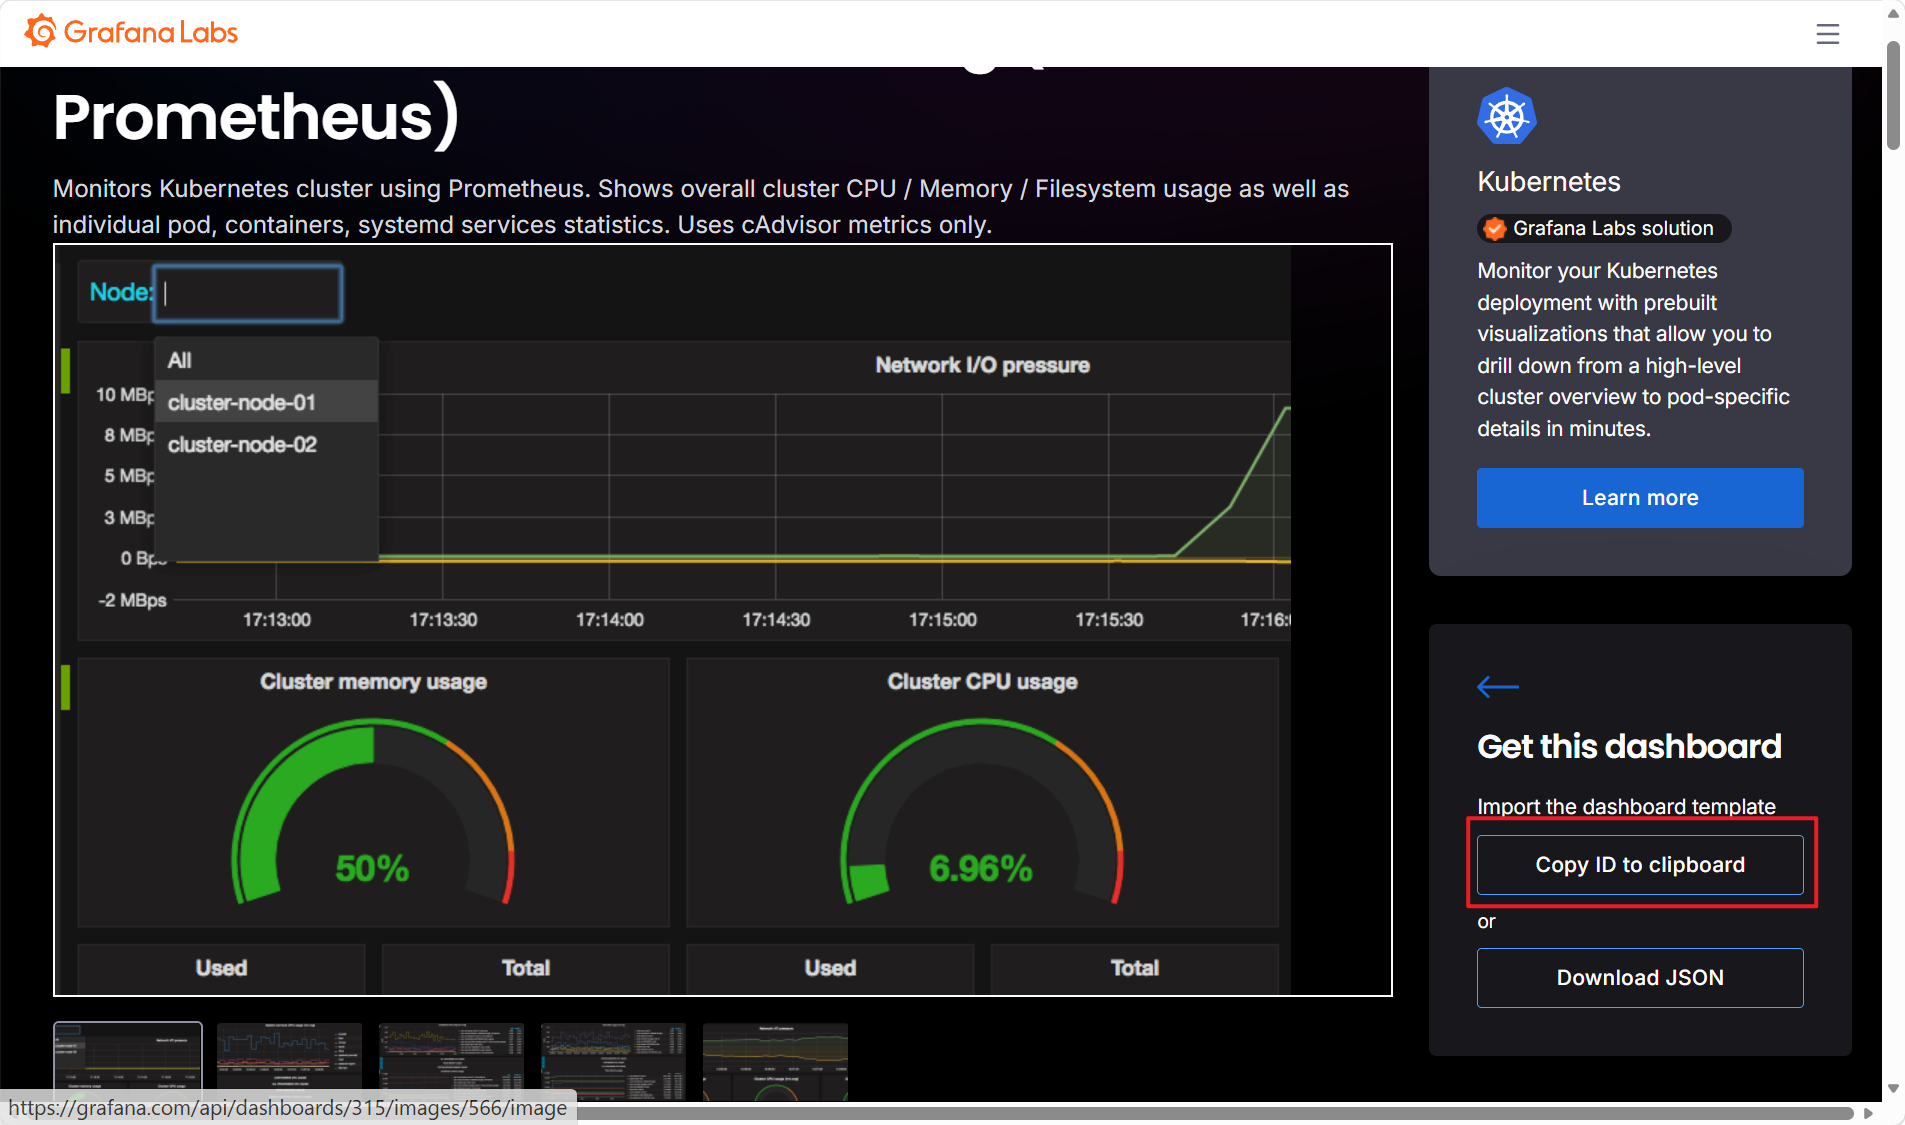
[Step2] 选择自己喜欢的模版,点击进行浏览,下拉点击“Copy ID to clipboard”。
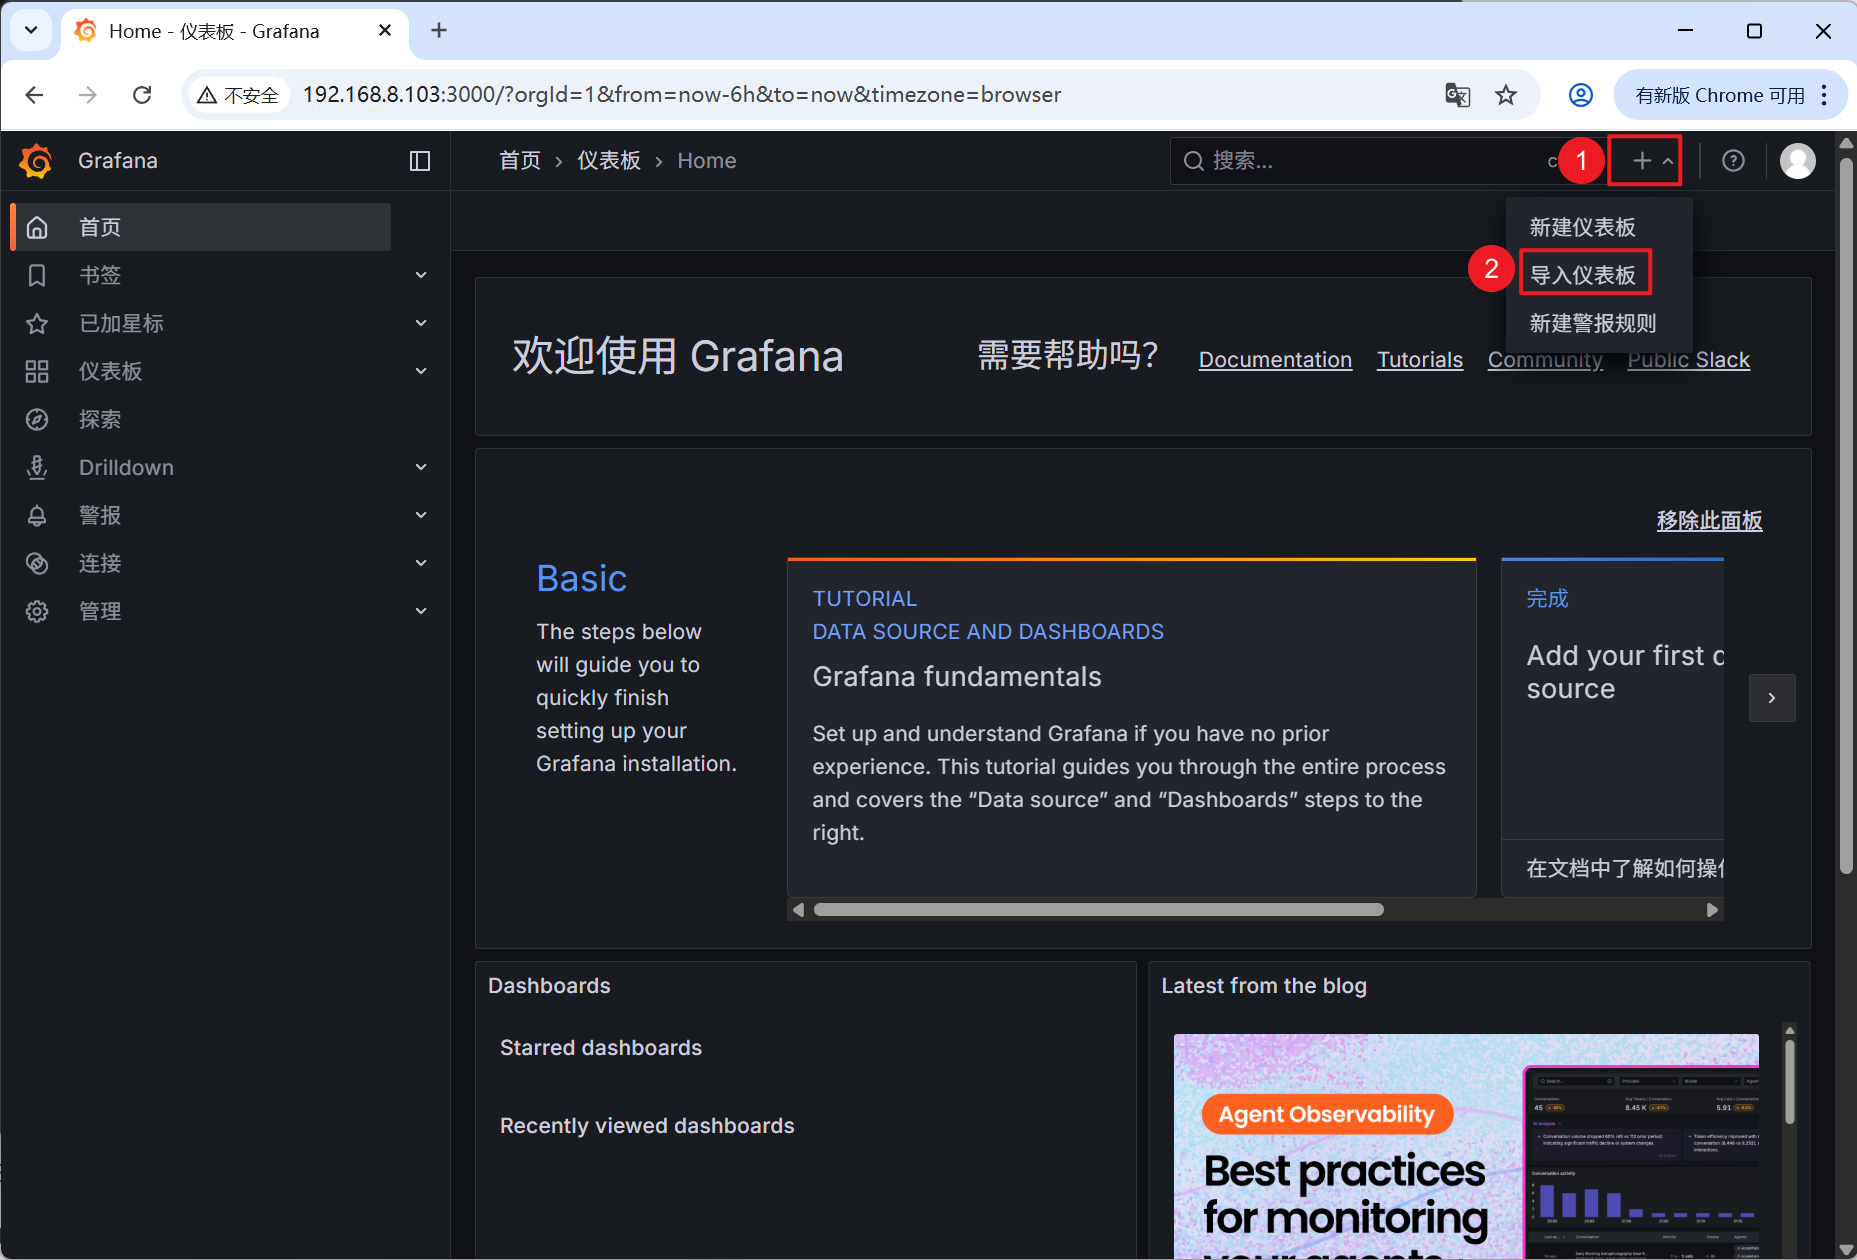
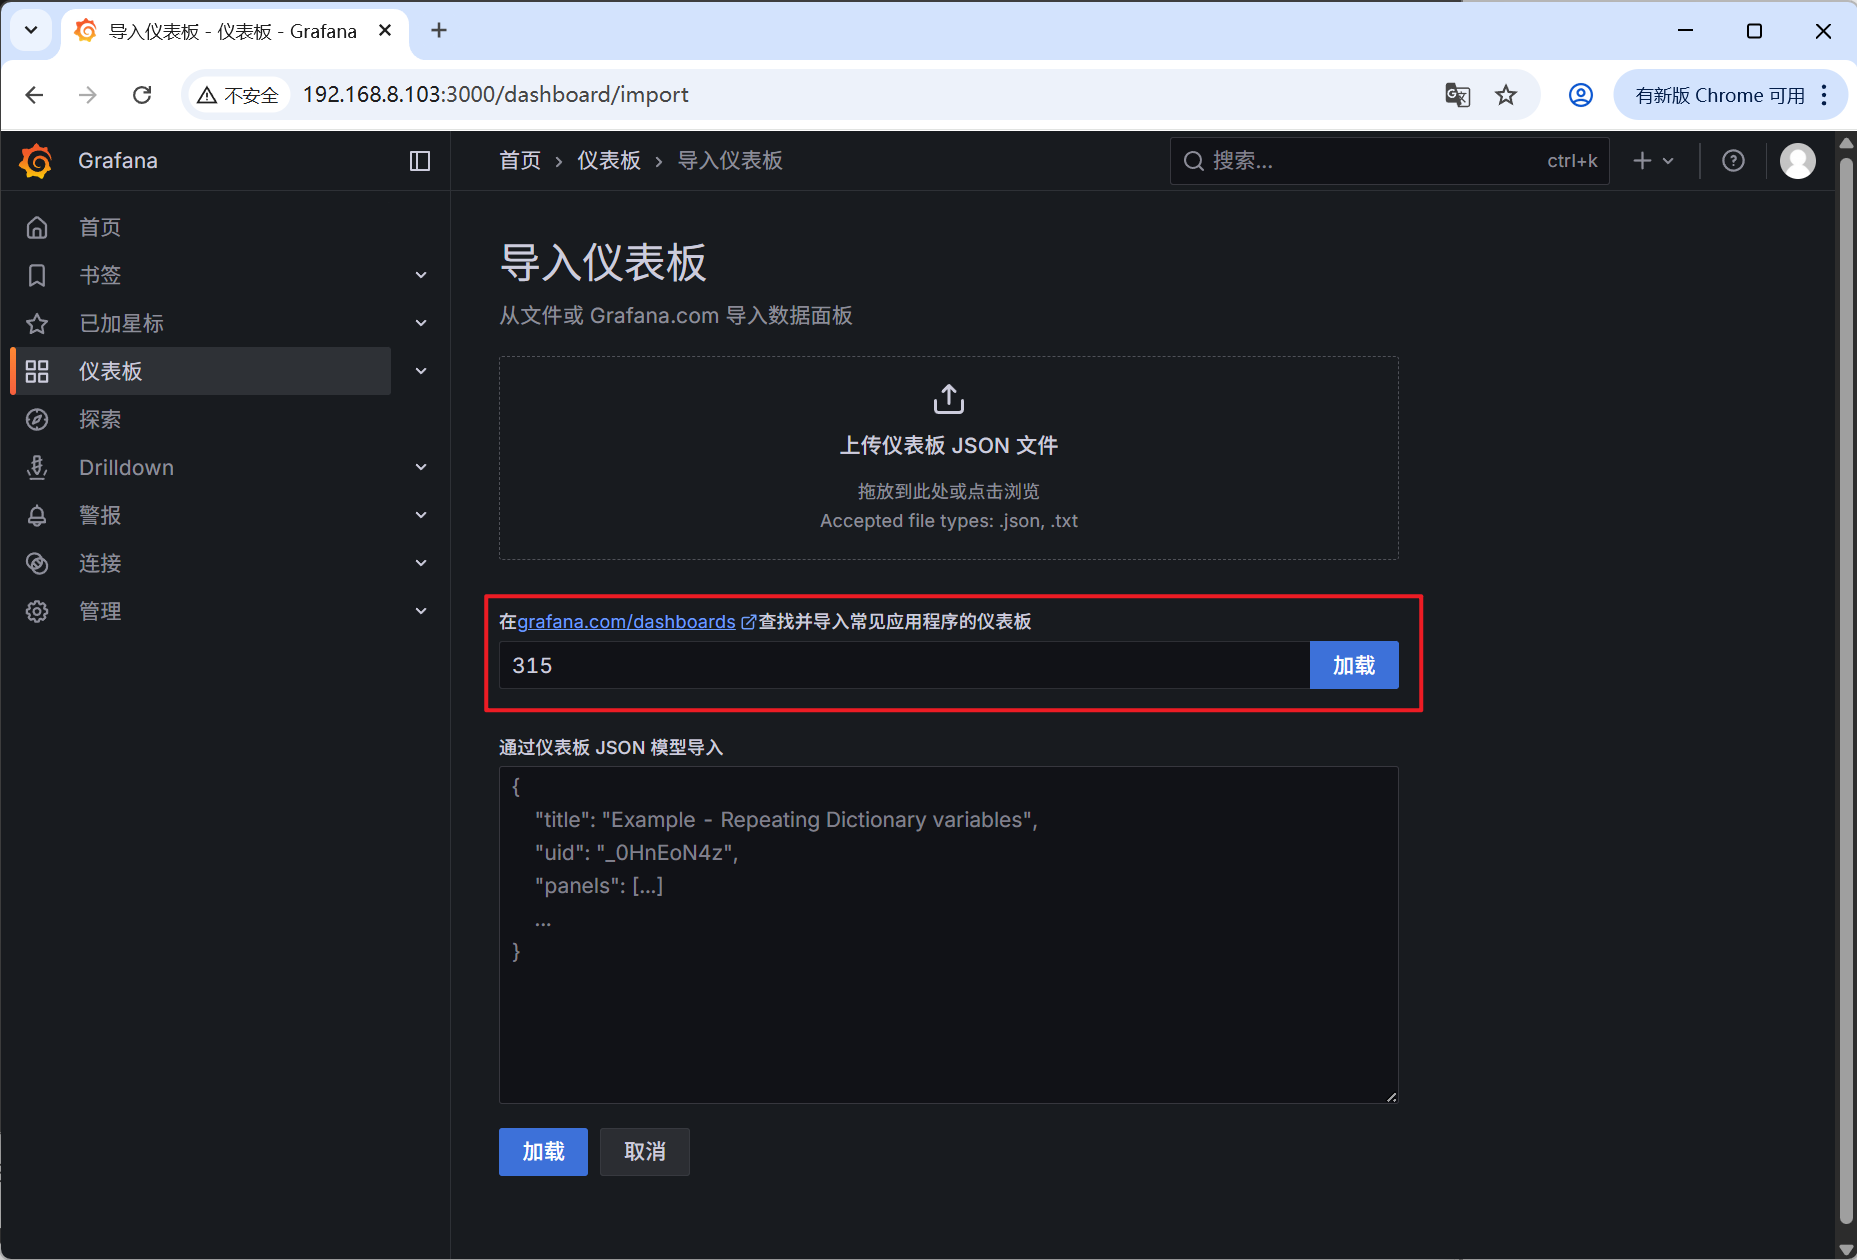
[Step3] 回到Grafana页面,点击右上角的“+”,然后选择“导入仪表板”。
[Step4] 粘贴刚刚复制的ID,然后点击“加载”。
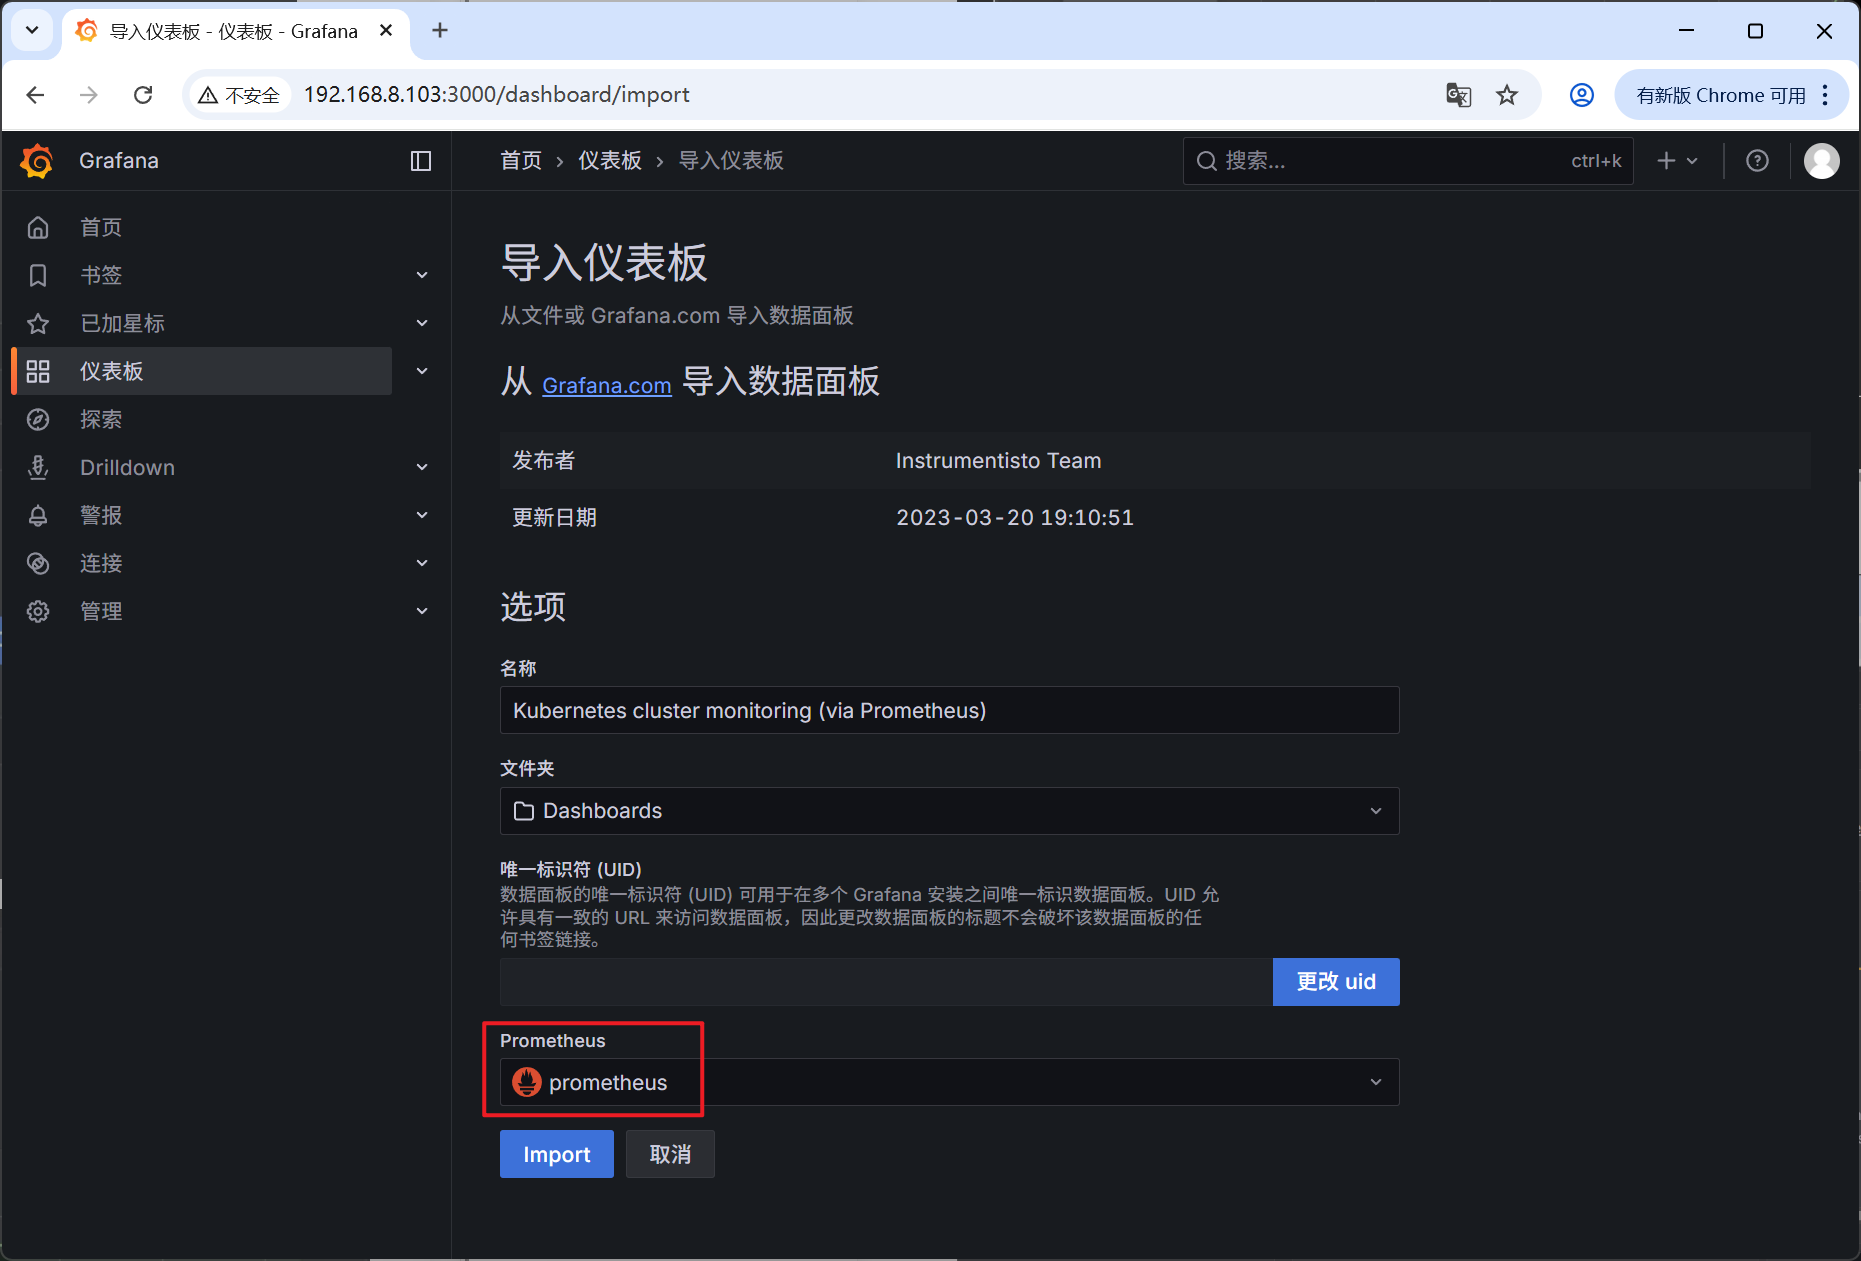
[Step5] 选择Prometheus数据源,然后点击“Import”。
[Step6] 此时页面中已展示监控面板基础视图,但部分指标暂无数据。监控组件启动后需要一定时间完成指标采集,等待片刻即可加载出完整监控数据。