
一、控制平面升级
1. 控制平面升级的目标与价值
对Kubernetes控制平面进行版本升级,是集群运维优化的核心操作,主要目的包含多方面:
安全加固,通过更新系统安全补丁、修复版本已知漏洞,有效规避安全风险,全面提升集群整体安全防护能力;
功能迭代,升级后可适配最新的Kubernetes接口规范,启用全新API资源与智能调度能力,丰富集群功能特性;
版本兼容维护,统一控制平面与工作节点的版本基线,保障集群各组件版本一致性,规避版本差异引发的兼容异常;
性能优化,依托新版核心组件的算法优化与机制升级,提升集群资源调度、生命周期管理的整体运行效率;
满足合规规范,适配企业运维标准与行业技术规范,达到集群运行的最低版本合规要求。
## 2. 控制平面升级流程
控制平面升级操作不会直接影响工作节点上业务负载的持续运行,但仍建议提前驱逐节点业务并完成集群数据备份。Kubernetes集群可借助kubeadm工具完成控制平面版本升级,整体流程分为以下步骤:
升级节点本地的kubeadm工具;
执行kubeadm命令升级控制平面核心组件,包含API Server、Controller Managerr、Scheduler;
完成kubelet与kubectl的版本更新;
【可选】升级etcd数据库,正式操作前建议先完成数据备份,防止数据丢失。
3. ETCD备份与恢复
etcd作为Kubernetes集群的核心数据库,持久化保存集群全部状态数据,涵盖各类资源对象定义(Pod、Service、Deployment、ConfigMap等)、集群网络、调度、认证相关配置以及控制平面组件运行状态。因此,做好etcd的备份与恢复,是保障集群高可用、实现故障容灾的关键手段。其主要价值体现在:
实现灾难恢复,当节点故障或数据异常丢失时复原集群状态;
控制平面版本升级前完成备份,规避升级风险;
支持集群数据迁移,将集群完整状态迁移至全新环境;
周期性创建数据快照,满足数据审计与异常回滚需求。
二、HPA案例配置
如果无法正常拉取镜像,可以访问我提供的百度云链接下载。
HPA组件包 https://pan.baidu.com/s/18oYx5ijpAsFnuR5ZQ2fotg?pwd=pfrd
提取码: pfrd
1. 创建Deployment和Service
[Step1] 本地新建YAML清单,定义Deployment资源描述模板。使用hpa-example镜像构建Deployment,该镜像是Kubernetes官方提供的HPA专用测试镜像,内部基于php-apache构建。页面内置一段CPU密集型运算代码,持续访问80端口时,Pod的CPU占用会快速上升,专门用于验证HPA水平自动扩缩容功能。
root@k8s-master:~# vim hpa-example-deployment.yml
# 写入下列内容
# 版本号,固定为apps/v1,如果1.9.0以前版本使用apps/v1beta2
apiVersion: apps/v1
kind: Deployment # 资源类型
metadata:
name: hpa-example-deployment
spec:
selector:
matchLabels: # 标签匹配模式:精确匹配
app: hpa-example # 匹配的标签值
template: # 对Pod模板的定义,至少要定义一个Label
metadata:
labels: # 给Pod加上标签,需要和selector定义一致
app: hpa-example
spec:
containers: # 定义容器的属性
- name: hpa-example-deployment
image: hpa-example:latest
imagePullPolicy: IfNotPresent
ports:
- containerPort: 80
resources:
limits:
cpu: 500m # CPU上限,最大0.5核
requests:
cpu: 300m # CPU资源请求0.3核[Step2] 根据YAML文件向Kubernetes集群声明式地创建Deployment资源。
root@k8s-master:~# kubectl create -f hpa-example-deployment.yml[Step3] 验证:基于文件内定义的资源清单,查询集群中该资源的运行状态与基础信息。
root@k8s-master:~# kubectl get -f hpa-example-deployment.yml
[Step4] 本地新建YAML清单,定义Service资源描述模板。
root@k8s-master:~# vim hpa-example-service.yml
# 写入下列内容
apiVersion: v1 # 固定配置
kind: Service # 资源类型
metadata:
name: hpa-example-service
labels: # 定义标签
app: hpa-example
spec:
ports:
- port: 80 # Service在集群内暴露的访问端口
selector: # 标签选择器,匹配后端Pod
app: hpa-example # 匹配后端Deployment标签[Step5] 根据YAML文件向Kubernetes集群声明式地创建Service资源。
root@k8s-master:~# kubectl create -f hpa-example-service.yml[Step6] 验证:基于文件内定义的资源清单,查询集群中该资源的运行状态与基础信息。
root@k8s-master:~# kubectl get -f hpa-example-service.yml
[Step7] 验证:通过Service地址访问hpa-example测试网页。
root@k8s-master:~# curl 10.111.143.44; echo;:表示连续执行两条命令
echo:默认情况下,hpa-example不会换行。这里为了美观,单独输出一个换行。

2. 创建HorizontalPodAutoscaler
[Step1] 本地新建YAML清单,定义HorizontalPodAutoscaler资源描述模板。创建HPA资源,设定CPU使用率阈值为50%。当Pod平均CPU利用率高于50%时,等待10秒稳定周期后执行扩容;当CPU利用率低于50%时,等待30秒稳定周期后执行缩容,避免瞬时流量波动引发频繁扩缩震荡。
root@k8s-master:~# vim hpa.yml
# 写入下列内容
apiVersion: autoscaling/v2 # 支持HPA多指标、自定义伸缩策略
kind: HorizontalPodAutoscaler # 资源类型
metadata:
name: hpa
namespace: default # 需要和绑定的Deployment处于同一命名空间
spec:
maxReplicas: 10 # Pod副本最大数量,扩容上限为10个
metrics: # 伸缩依据的监控指标配置
- resource:
name: cpu # 采集指标为CPU
target:
averageUtilization: 50 # CPU使用阈值为50%
type: Utilization # 按照利用率方式计算
type: Resource # 指标类别:系统基础资源指标
minReplicas: 1 # Pod副本最小数量,缩容下限为1
scaleTargetRef: # 指定HPA管理的目标工作负载
apiVersion: apps/v1
kind: Deployment
name: hpa-example-deployment # 绑定名称Deployment
behavior: # 自定义扩缩容策略稳定窗口
scaleUp: # 扩容相关配置
# 当监测到CPU负载高于阈值,不会立刻扩容,持续等待10秒;如果10秒过后负载依旧超标,才执行扩容。
stabilizationWindowSeconds: 10
scaleDown: # 缩容相关配置
# 当监测到CPU负载低于阈值,持续等待30秒;30秒内负载持续偏低,才执行缩容。
stabilizationWindowSeconds: 30[Step2] 根据YAML文件向Kubernetes集群声明式地创建HorizontalPodAutoscaler资源。
root@k8s-master:~# kubectl create -f hpa.yml[Step3] 验证:基于文件内定义的资源清单,查询集群中该资源的运行状态与基础信息。
root@k8s-master:~# kubectl get -f hpa.yml
3. 验证
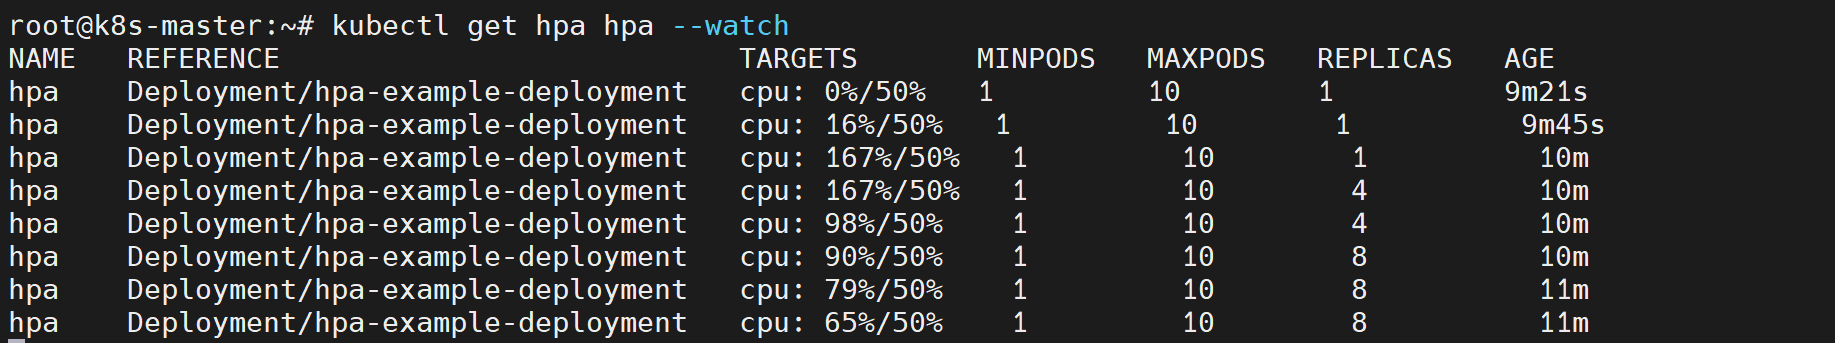
[Step1] 实时监控名称为hpa的水平自动扩缩器状态,动态刷新展示指标负载、当前副本数、目标副本数变化。
root@k8s-master:~# kubectl get hpa hpa --watch[Step2] 在k8s-worker1和k8s-worker2上同时连续访问hpa-example测试网页。
root@k8s-worker1:~# while sleep 0.01; do wget -q -O- http://10.111.143.44; done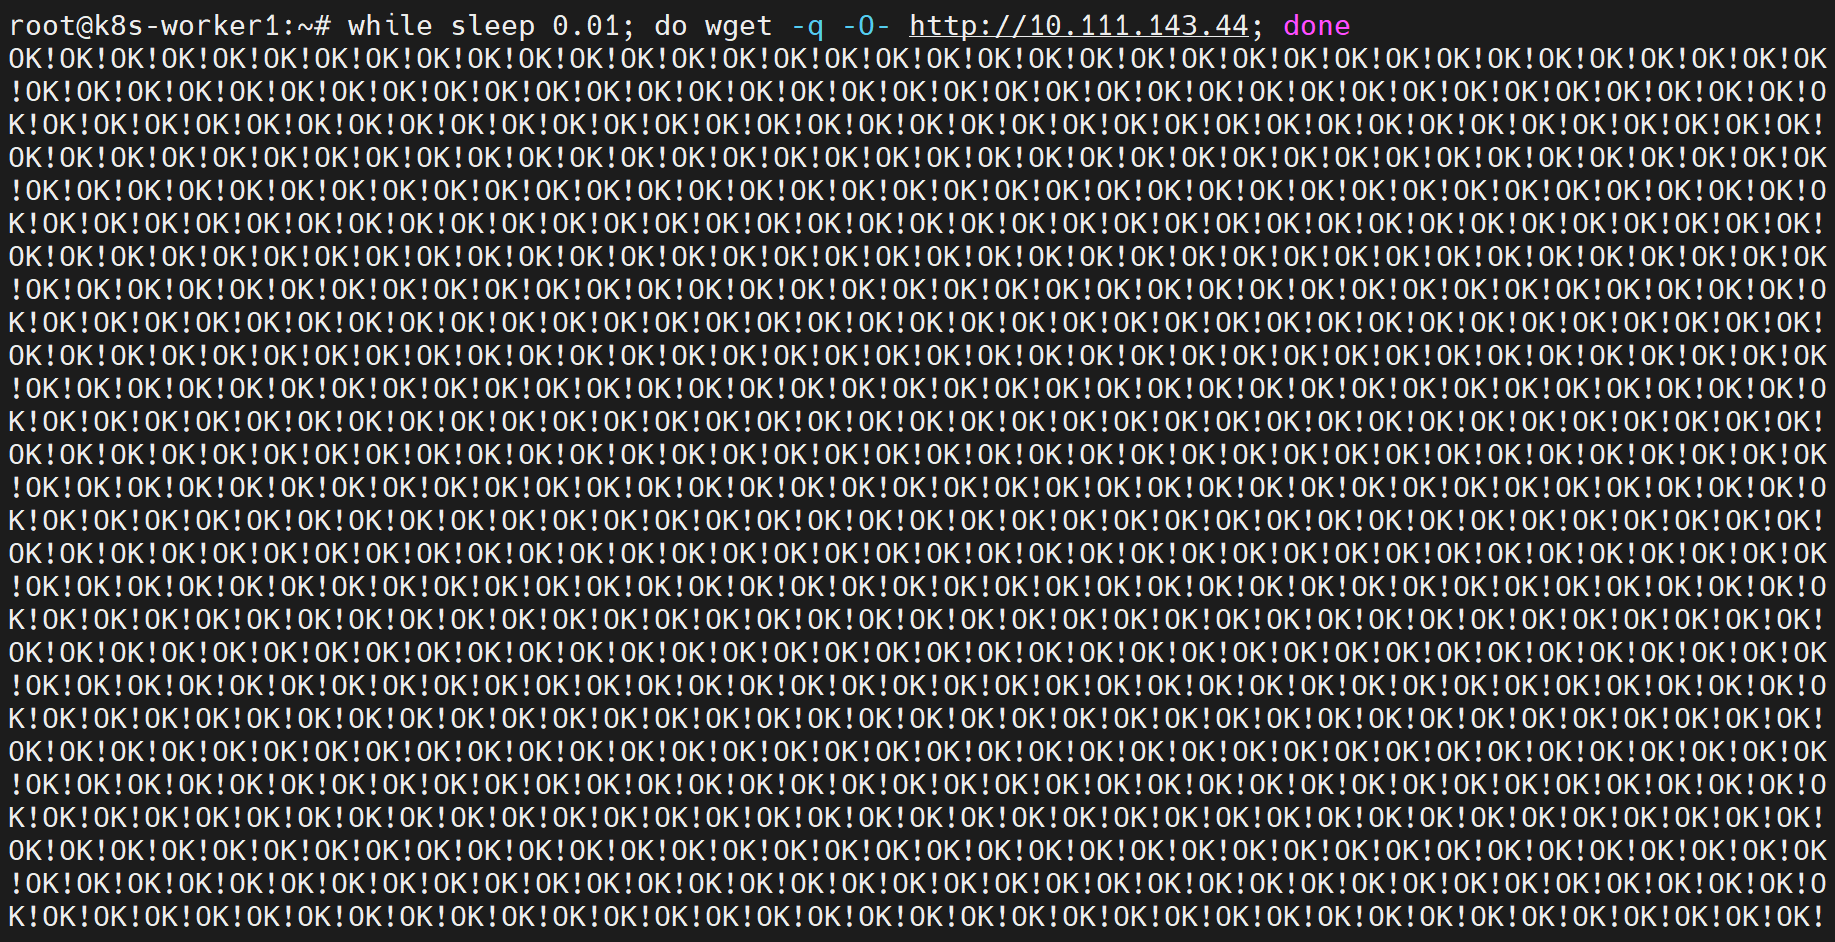
[Step3] 观察命令的回显结果,可以看到当占用率升高的是时候,副本数会自动增加。
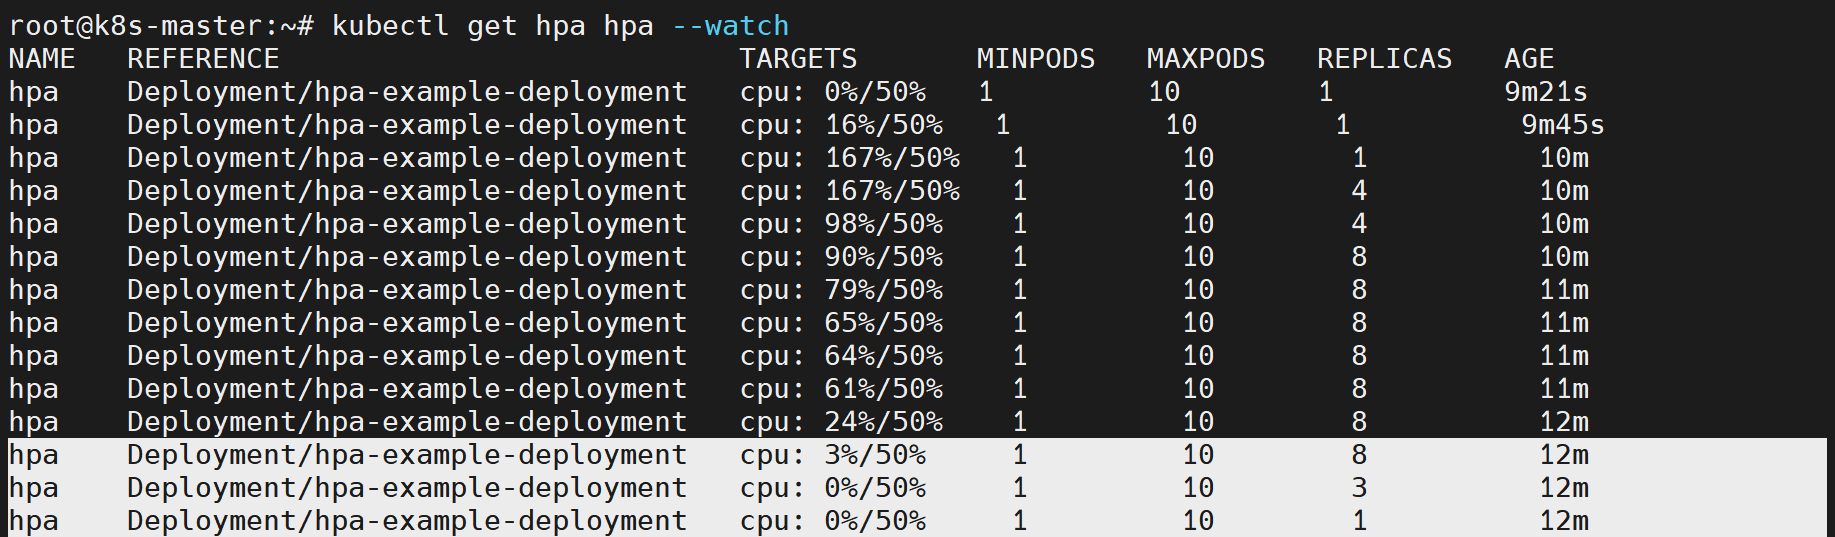
[Step4] 将脚本终止,然后观察回显结果。可以看到当占用率下降时,副本数自动减少。
三、控制平面升级案例
1. 封锁控制平面节点
[Step1] 查看当前kubeadm版本。
root@k8s-master:~# kubeadm version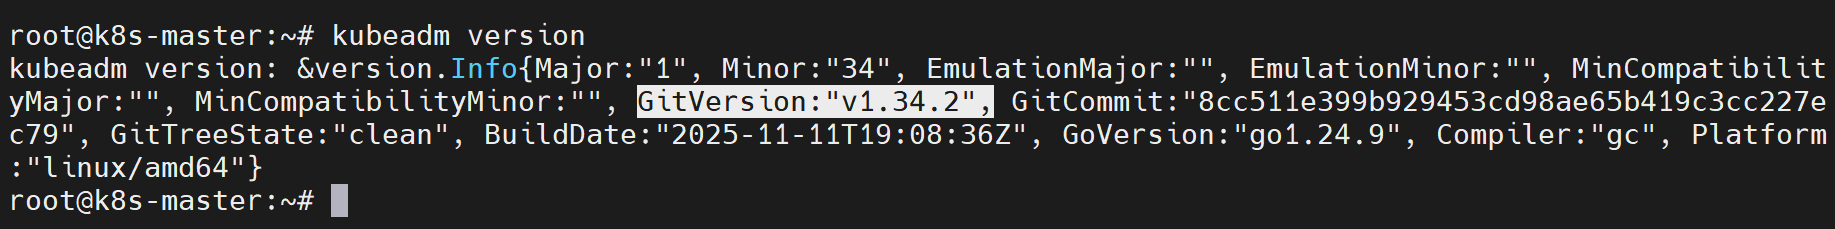
[Step2] 更新当前APT源,然后列出当前软件源中所有可供安装的版本。
root@k8s-master:~# apt-get update
root@k8s-master:~# apt list kubeadm -a
kubeadm/unknown 1.34.10-1.1 amd64 [upgradable from: 1.34.2-1.1]:当前系统已安装版本1.34.2-1.1,存在更高版本可升级
kubeadm/unknown,now 1.34.2-1.1 amd64 [installed,upgradable to: 1.34.10-1.1]:软件源内最新可用版本为1.34.10-1.1,可从现有1.34.2直接升级。
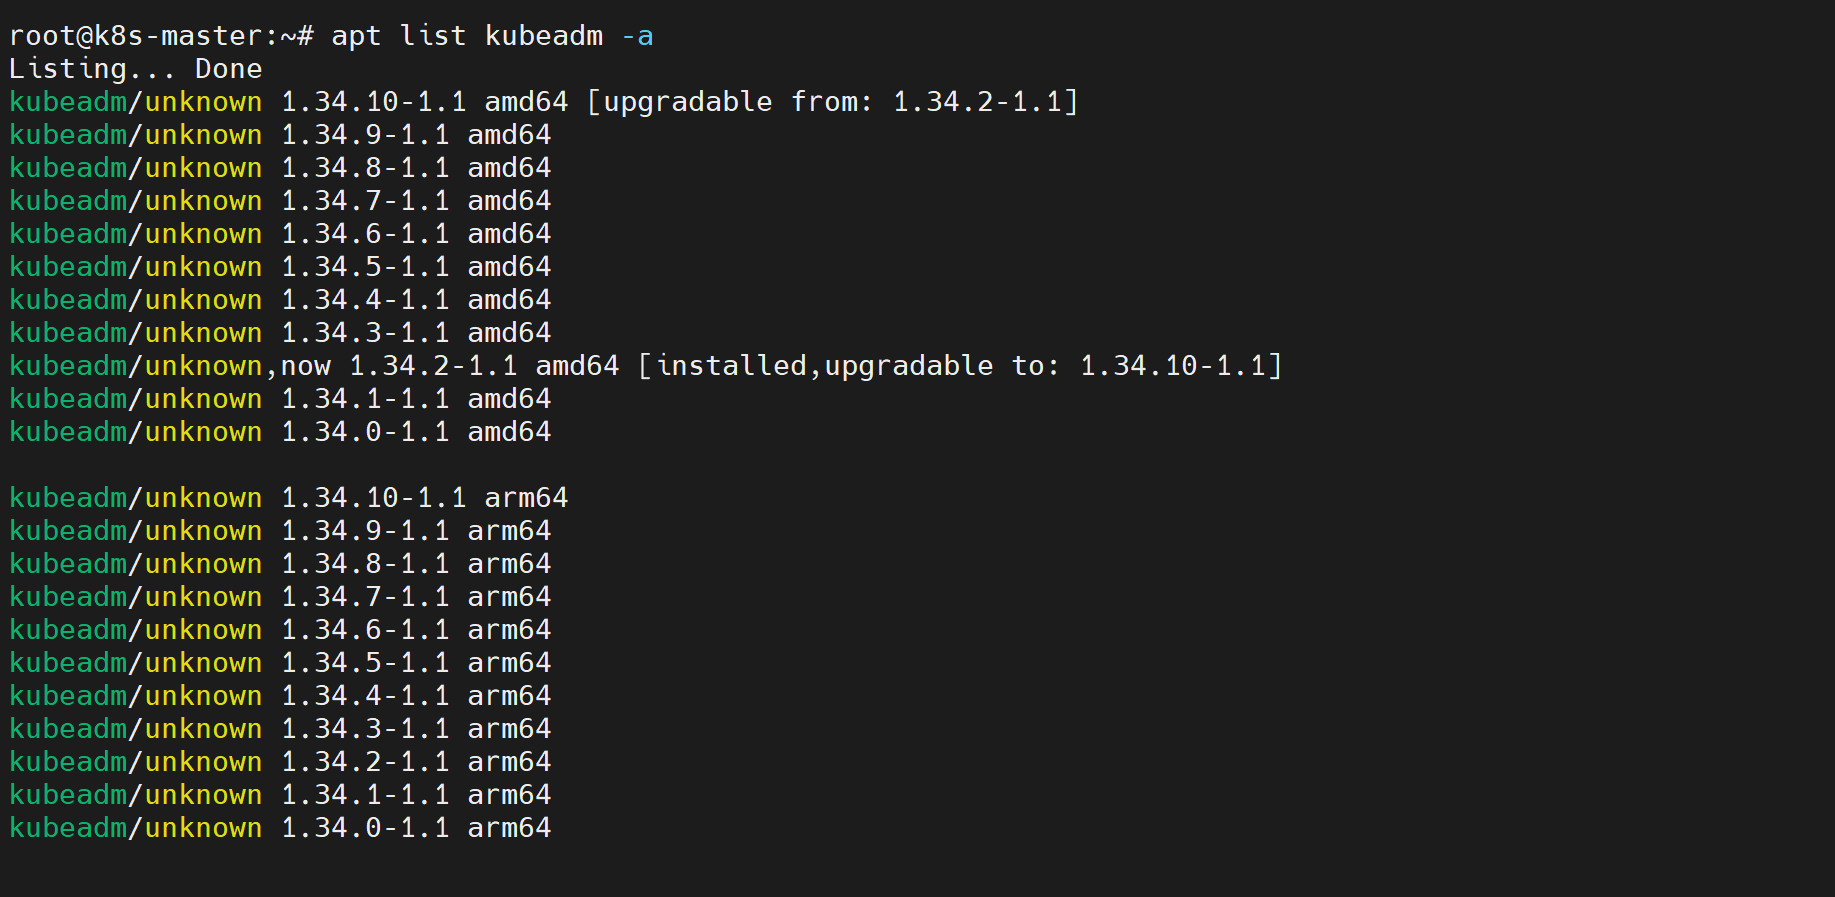
[Step3] 这里我们将版本升级为1.34.10,将Master节点标记为不可调度。
root@k8s-master:~# kubectl cordon k8s-master
root@k8s-master:~# kubectl get nodes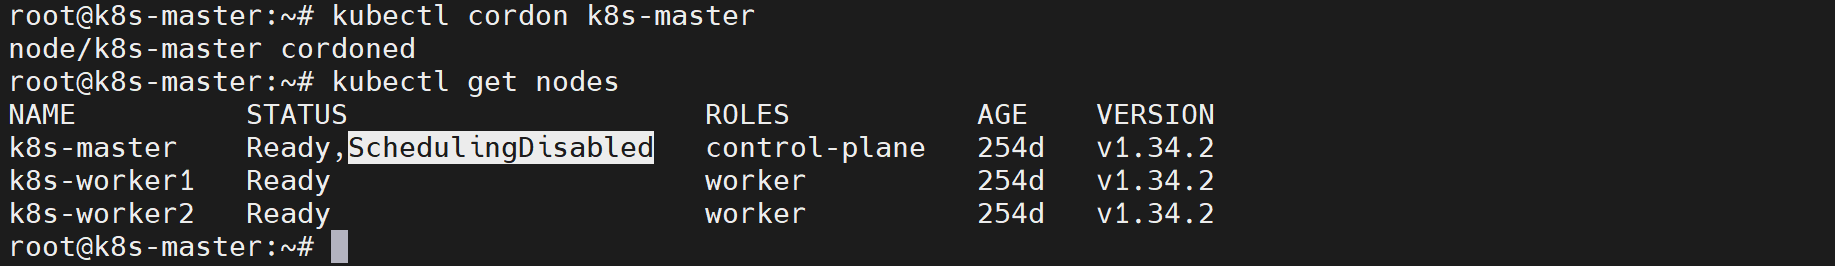
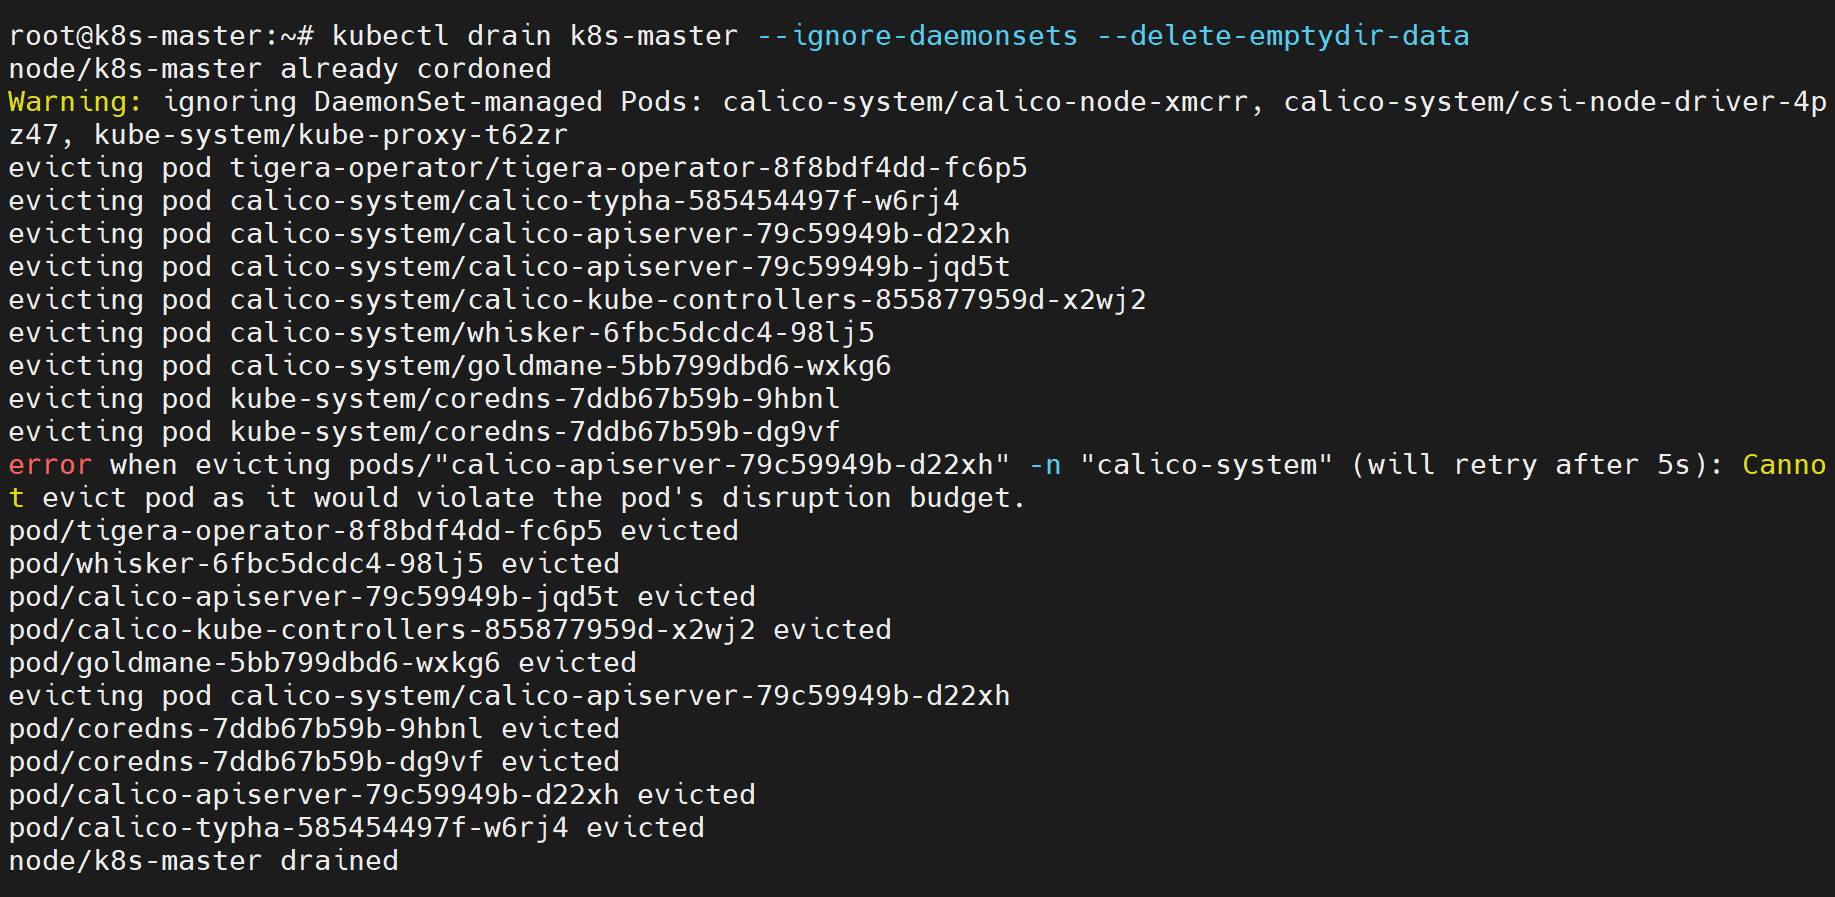
[Step4] 封锁k8s-master节点,并驱逐该节点上所有工作负载Pod。忽略DaemonSet类型Pod不进行驱逐,同时允许移除挂载emptyDir临时存储的Pod。
root@k8s-master:~# kubectl drain k8s-master --ignore-daemonsets --delete-emptydir-datakubectl drain:腾空节点,驱逐节点上所有Pod,同时自动执行cordon封锁节点,禁止新Pod调度进来。
--ignore-daemonsets:忽略DaemonSet控制器管理的Pod(如Filebeat、NodeExporter等)。DaemonSet Pod需要常驻各个节点,如果不添加该参数,drain命令会报错,无法执行。
--delete-emptydir-data:允许删除使用emptyDir类型临时存储的Pod,emptyDir数据跟随Pod生命周期,Pod删除后数据永久丢失。不加此参数,存在emptyDir的Pod会阻止drain执行。
2. 控制平面升级
[Step1] 执行apt命令升级kubeadm、kubelet、kubectl软件包,此步骤仅更新节点本地二进制程序,尚未完成Kubernetes控制平面升级。
root@k8s-master:~# apt-get install -y kubelet=1.34.10-1.1 kubeadm=1.34.10-1.1 kubectl=1.34.10-1.1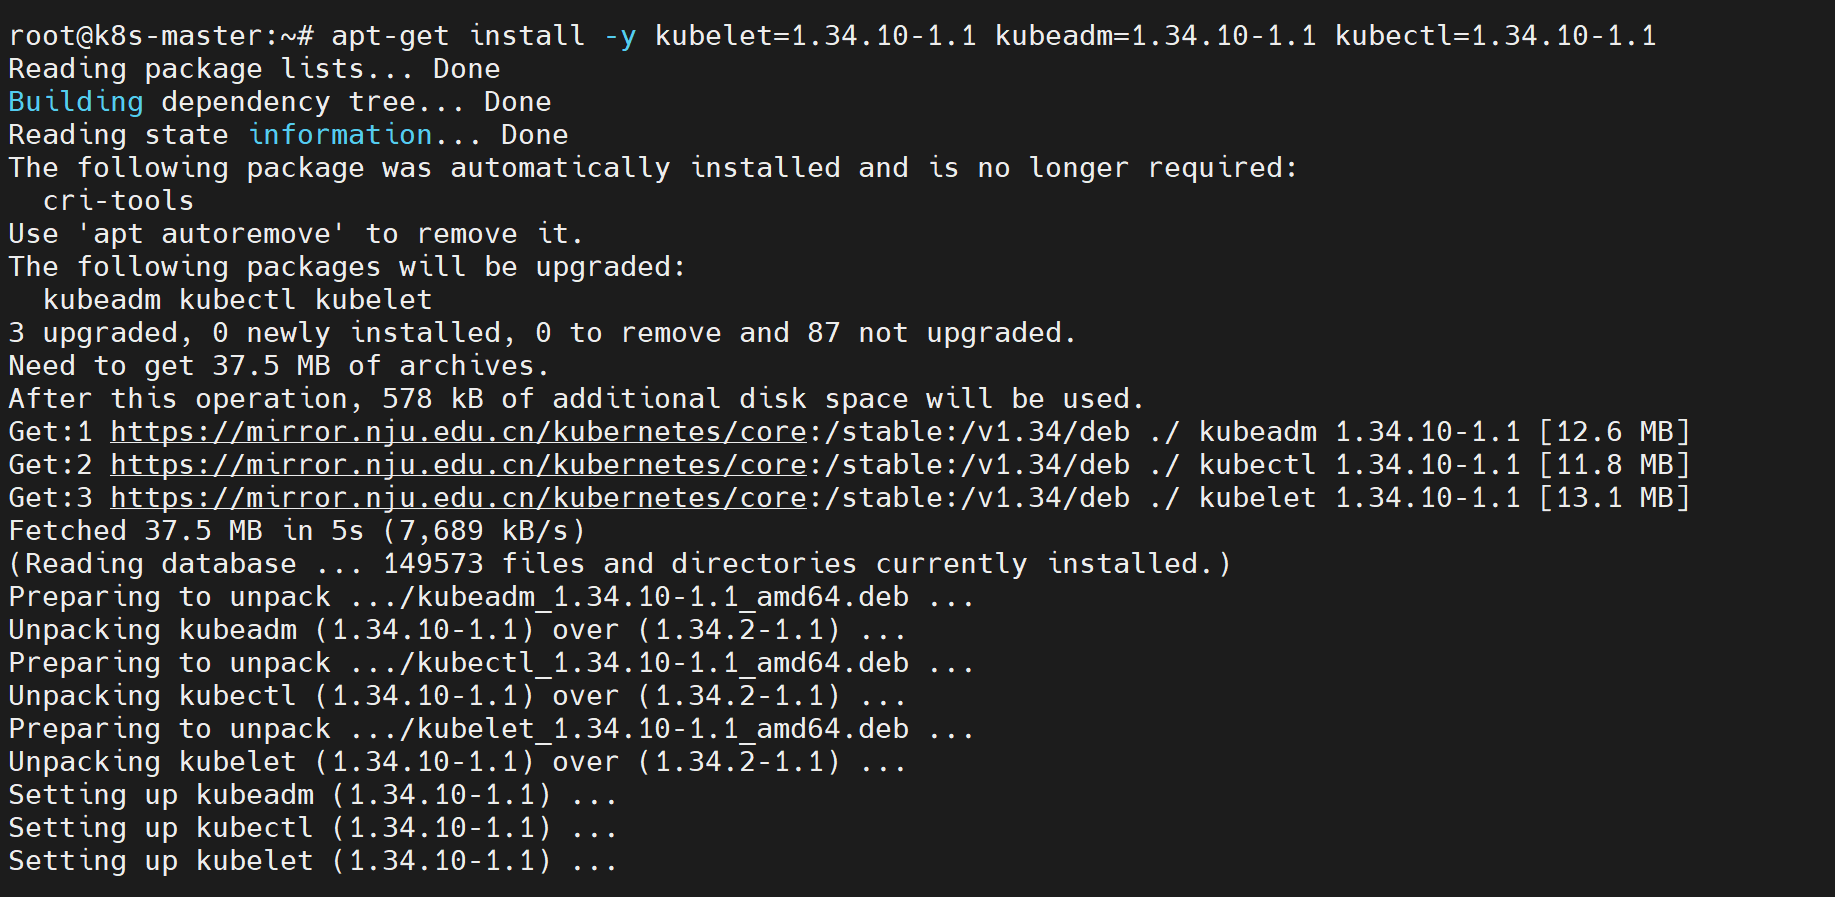
[Step2] 检查并输出控制平面升级方案,模拟升级规划,此时不会执行任何变更。
root@k8s-master:~# kubeadm upgrade plan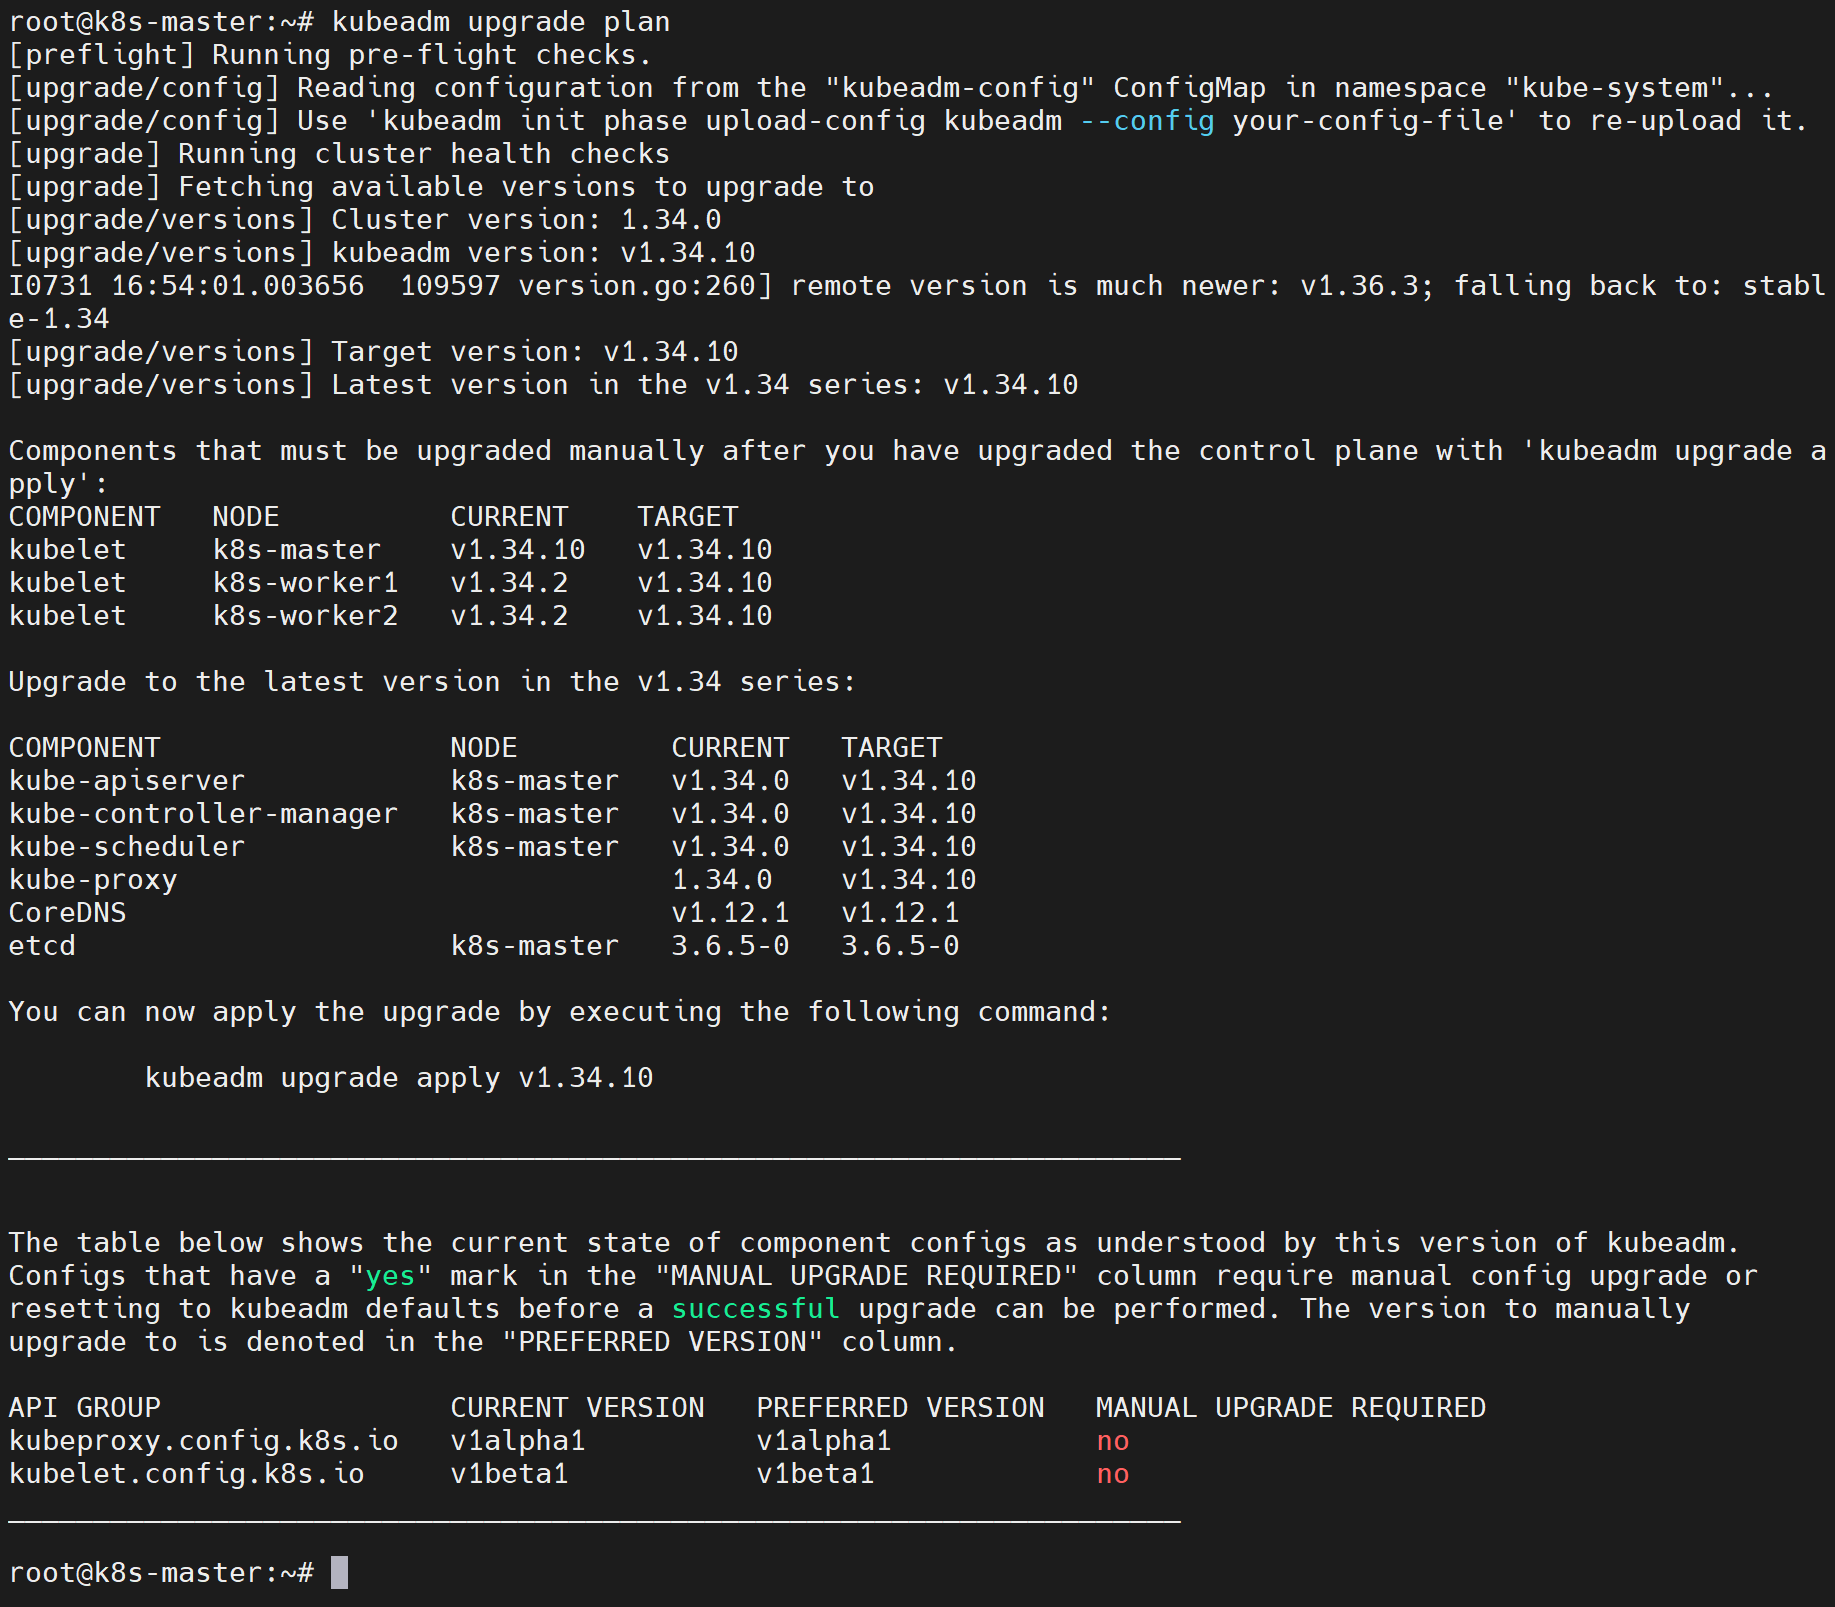
[Step3] 这里跳过etcd升级,避免出现数据风险,可以提前备份etcd中数据。
root@k8s-master:~# kubeadm upgrade apply 1.34.10 --etcd-upgrade=false
[upgrade] Are you sure you want to proceed? [y/N]: y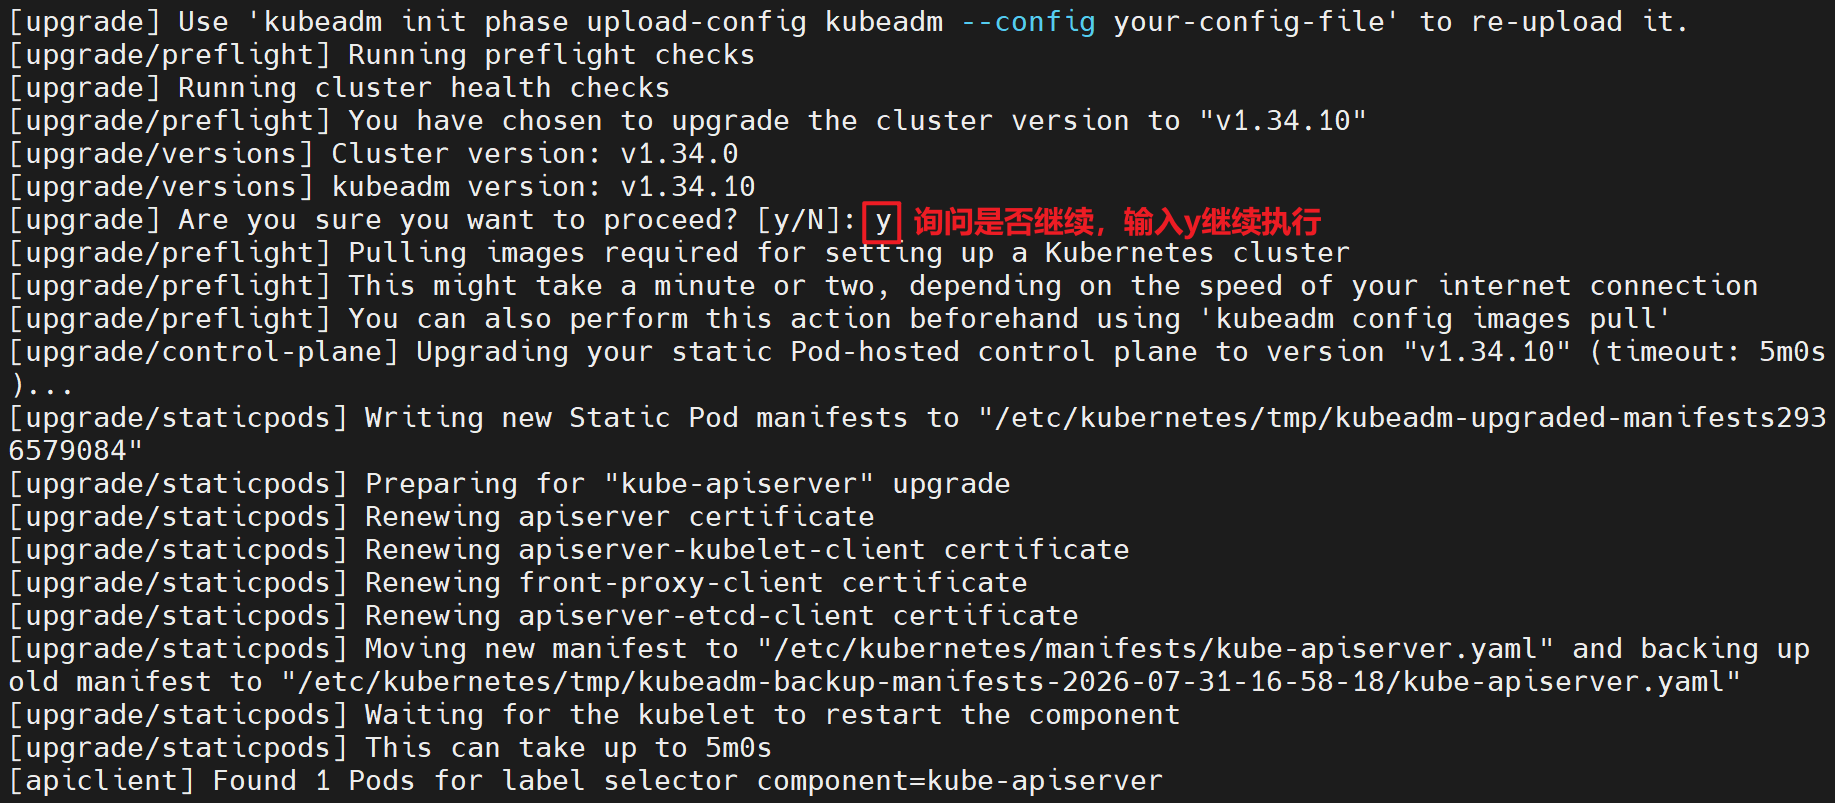
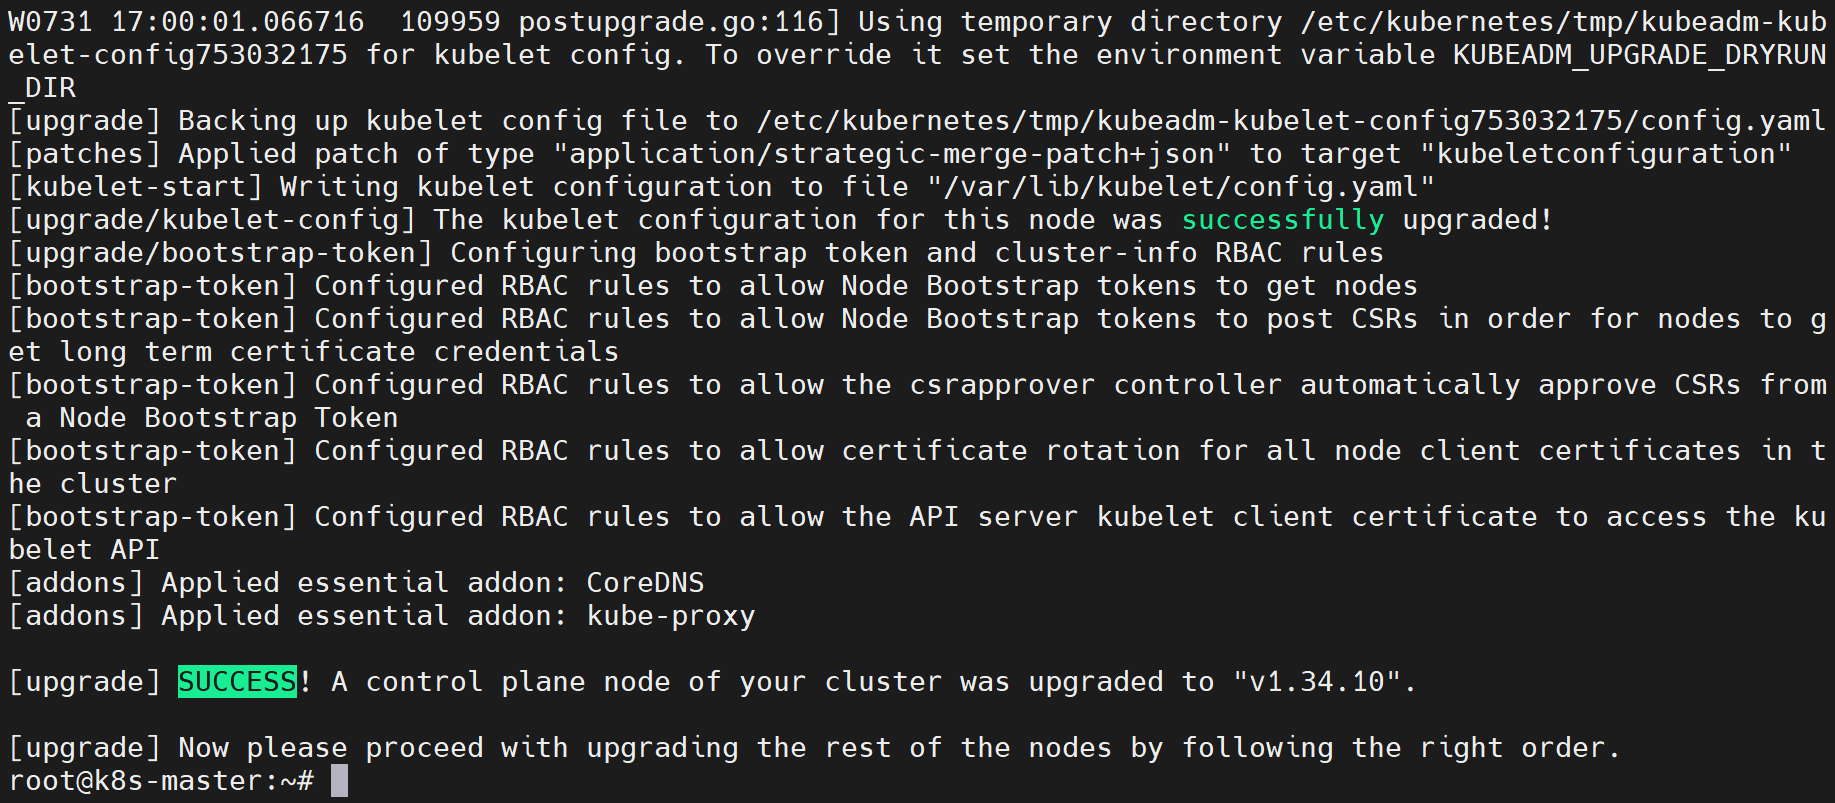
[Step4] 重启kubelet并解除cordon,恢复Master节点的调度能力。观察节点信息可见两台工作节点版本尚未更新。原因在于kubeadm upgrade apply仅负责升级控制平面相关组件,不会自动更新各节点本地的kubelet二进制程序,需要登录worker节点手动执行软件包安装命令,并重启kubelet服务完成版本升级。
root@k8s-master:~# systemctl restart kubelet.service
root@k8s-master:~# kubectl uncordon k8s-master
root@k8s-master:~# kubectl get nodes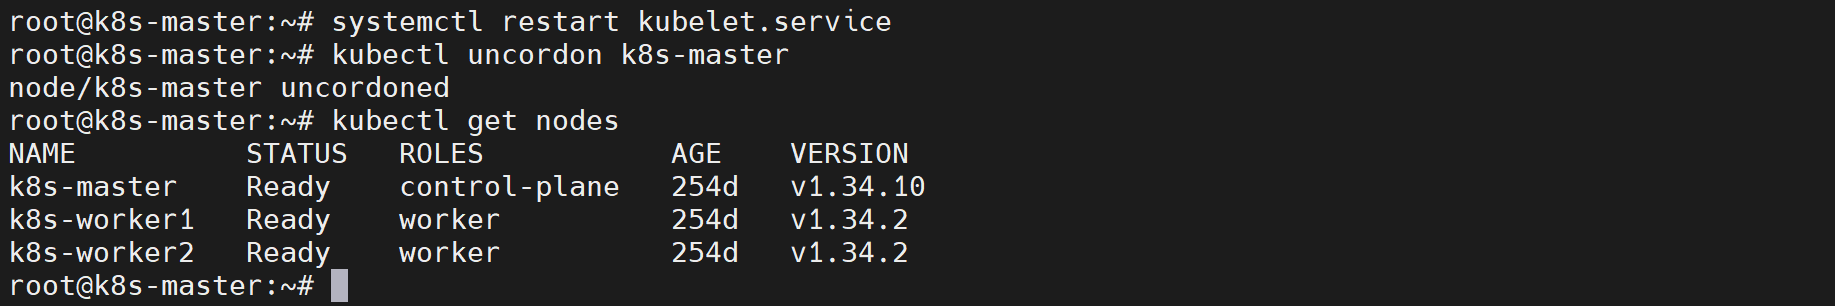
3. 工作节点升级
按照Kubernetes升级规范,应该逐个升级worker节点,不建议同时操作所有工作节点,避免业务整体中断。
[Step1] 在工作节点k8s-worker1升级kubeadm、kubelet、kubectl至1.34.10版本。
root@k8s-worker1:~# apt-get update
root@k8s-worker1:~# apt-get install -y kubelet=1.34.10-1.1 kubeadm=1.34.10-1.1 kubectl=1.34.10-1.1
[Step2] 在工作节点k8s-worker2升级kubeadm、kubelet、kubectl至1.34.10版本。
root@k8s-worker2:~# apt-get update
root@k8s-worker2:~# apt-get install -y kubelet=1.34.10-1.1 kubeadm=1.34.10-1.1 kubectl=1.34.10-1.1
[Step3] 在工作节点k8s-worker1重启kubelet服务,加载新版本程序。
root@k8s-worker1:~# systemctl restart kubelet.service[Step4] 在工作节点k8s-worker2重启kubelet服务,加载新版本程序。
root@k8s-worker2:~# systemctl restart kubelet.service[Step5] 在控制平面查看节点详细信息,可以看kubelet版本升级成功。
root@k8s-master:~# kubectl get nodes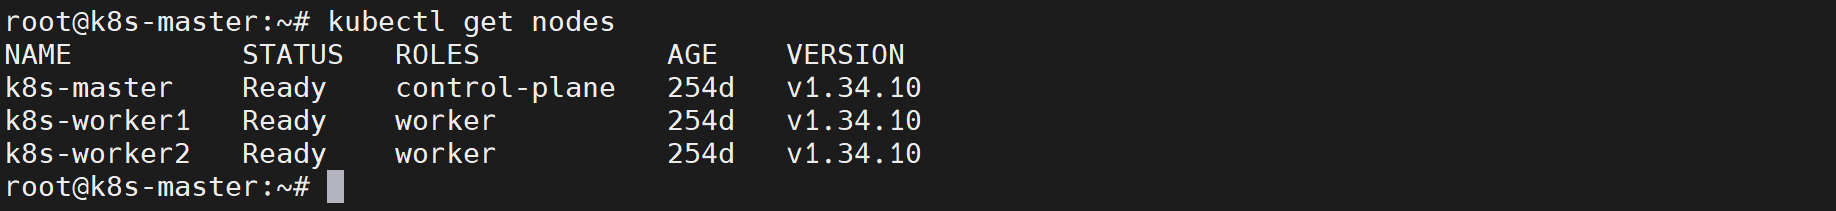
四、ETCD备份与恢复案例
1. ETCD备份
[Step1] 安装ETCD客户端。
root@k8s-master:~# apt-get update
root@k8s-master:~# apt-get install -y etcd-client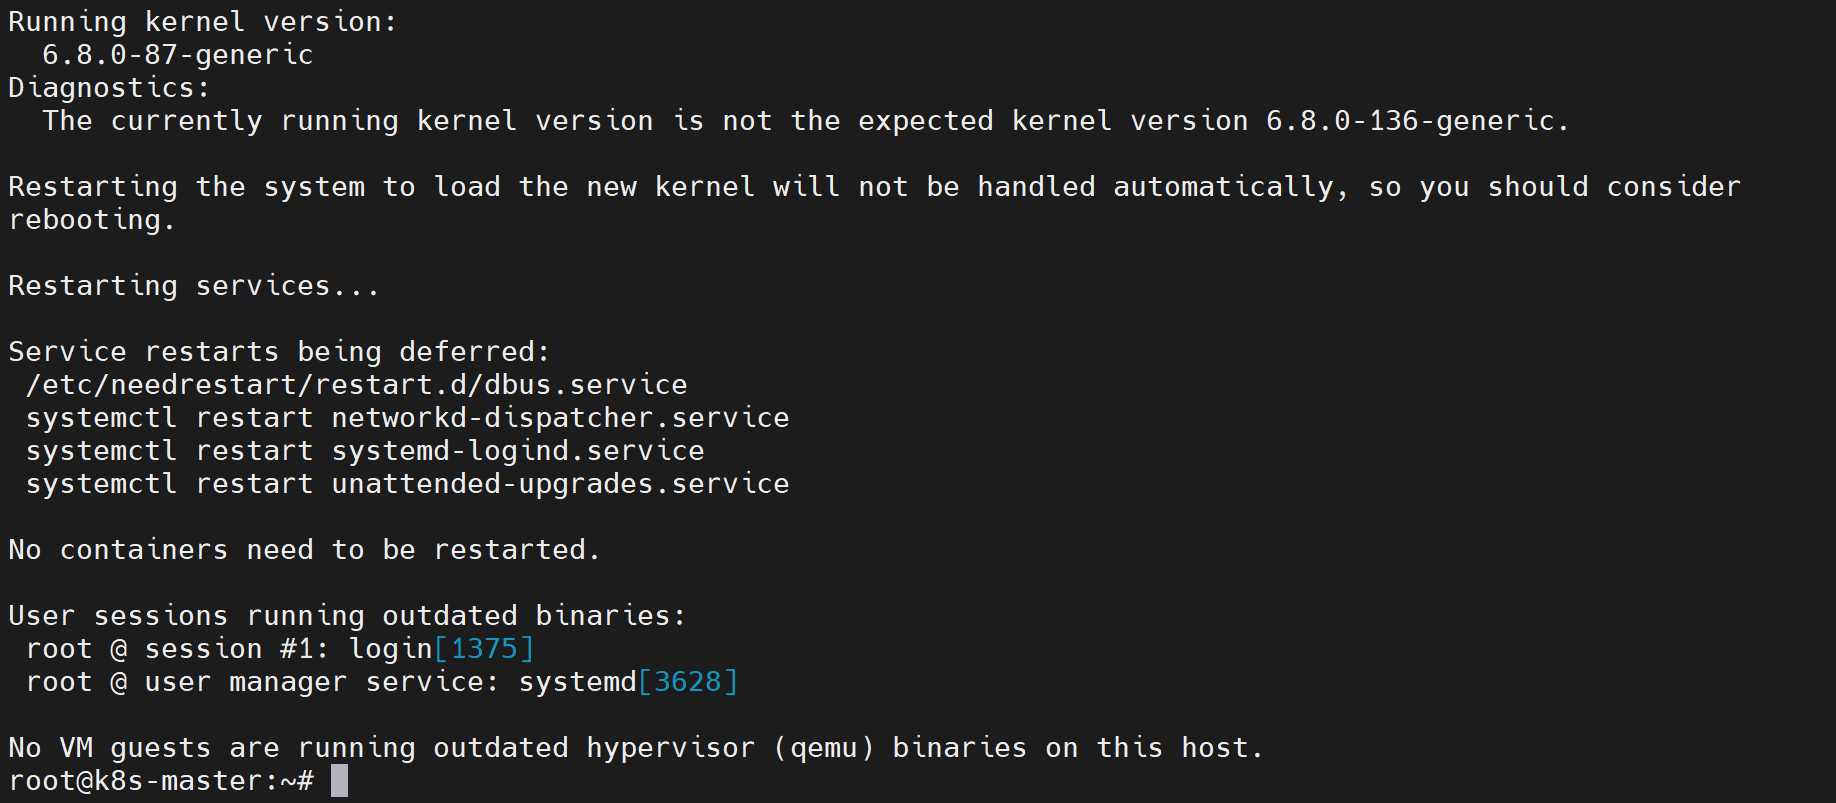
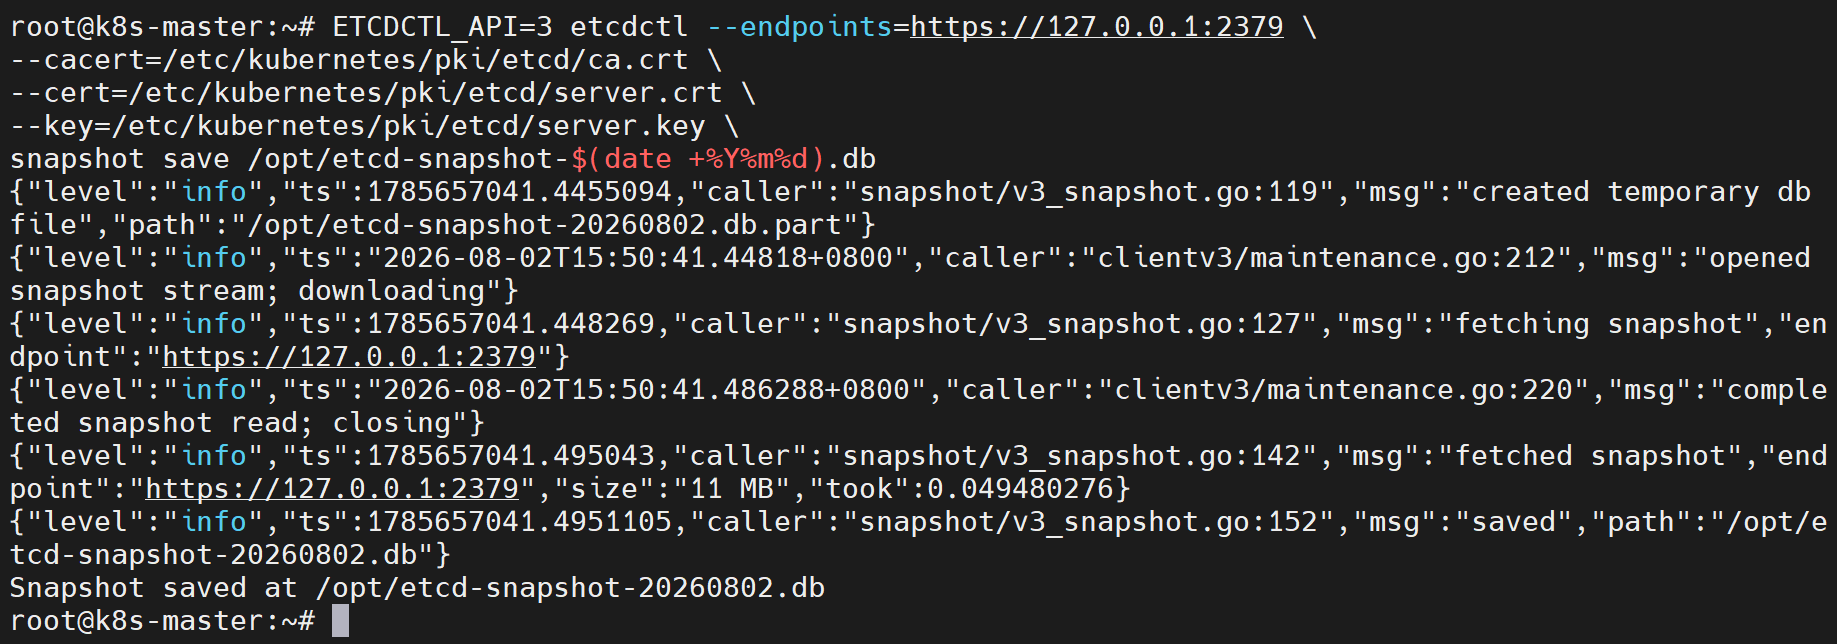
[Step2] 采用etcdctl v3对etcd数据库进行快照备份,命令携带通信地址、CA证书、服务证书与私钥,生成一致性快照文件,备份结束后可校验快照状态。
root@k8s-master:~# ETCDCTL_API=3 etcdctl --endpoints=https://127.0.0.1:2379 \
--cacert=/etc/kubernetes/pki/etcd/ca.crt \
--cert=/etc/kubernetes/pki/etcd/server.crt \
--key=/etc/kubernetes/pki/etcd/server.key \
snapshot save /opt/etcd-snapshot-$(date +%Y%m%d).dbETCDCTL_API=3:指定使用etcd API v3,快照备份仅支持API3。
etcdctl:ETCD官方命令客户端工具,用于和ETCD服务交互。
--endpoints=https://127.0.0.1:2379:指定连接的etcd服务地址。
--cacert=/etc/kubernetes/pki/etcd/ca.crt:CA根证书文件,校验etcd服务端证书合法性
--cert=/etc/kubernetes/pki/etcd/server.crt:客户端证书,server.crt为客户端访问etcd使用
--key=/etc/kubernetes/pki/etcd/server.key:客户端证书对应的私钥,与cert配套使用
snapshot save:在线生成etcd全量快照备份,无需停止etcd,在线备份集群所有数据。
[Step3] 验证:查看etcd快照文件的元数据信息,校验快照文件是否完好、读取快照内部统计信息。
root@k8s-master:~# ETCDCTL_API=3 etcdctl --write-out=table \
snapshot status /opt/etcd-snapshot-20260802.db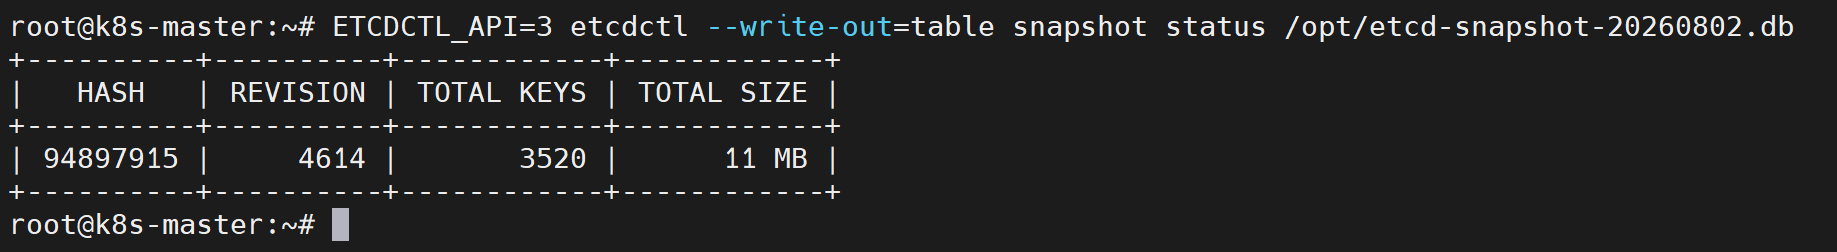
2. ETCD恢复
[Step1] 停止kubelet服务,执行ETCD数据快照恢复。
root@k8s-master:~# systemctl stop kubelet.service
root@k8s-master:~# ETCDCTL_API=3 etcdctl --endpoints 127.0.0.1:2379 \
snapshot restore /opt/etcd-snapshot-20260802.db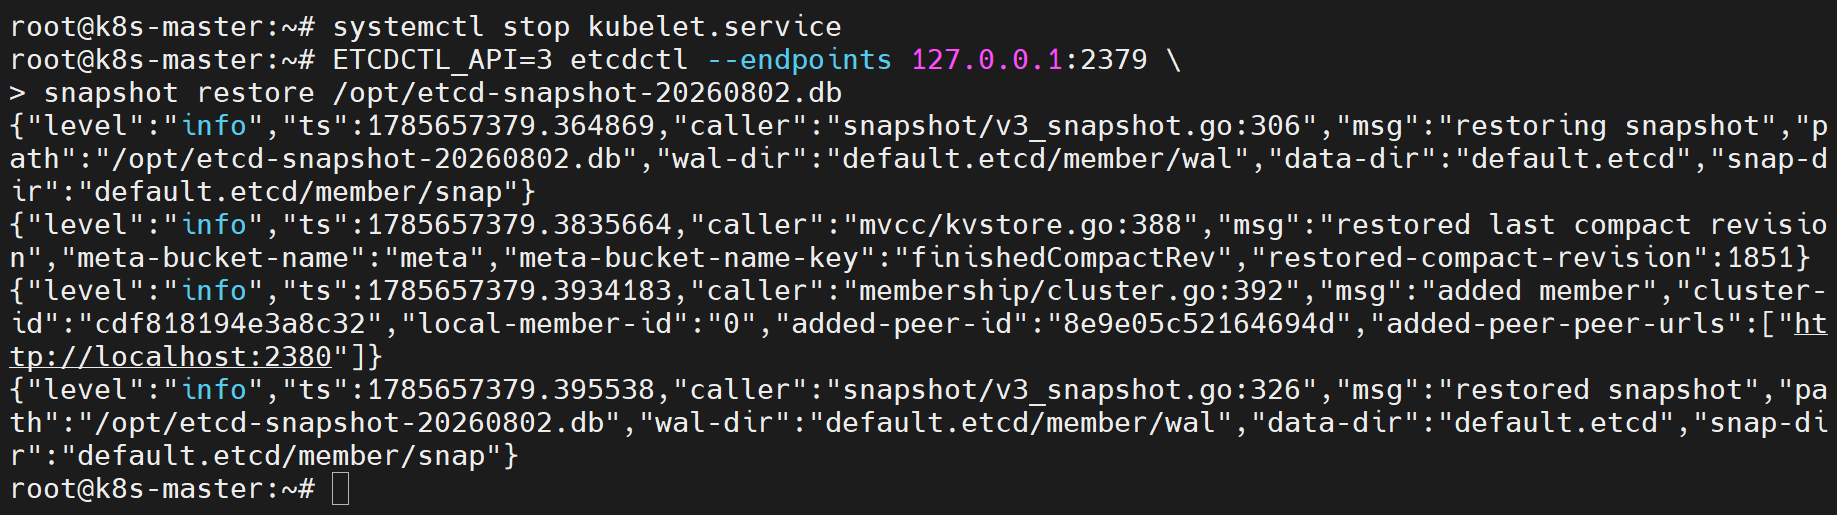
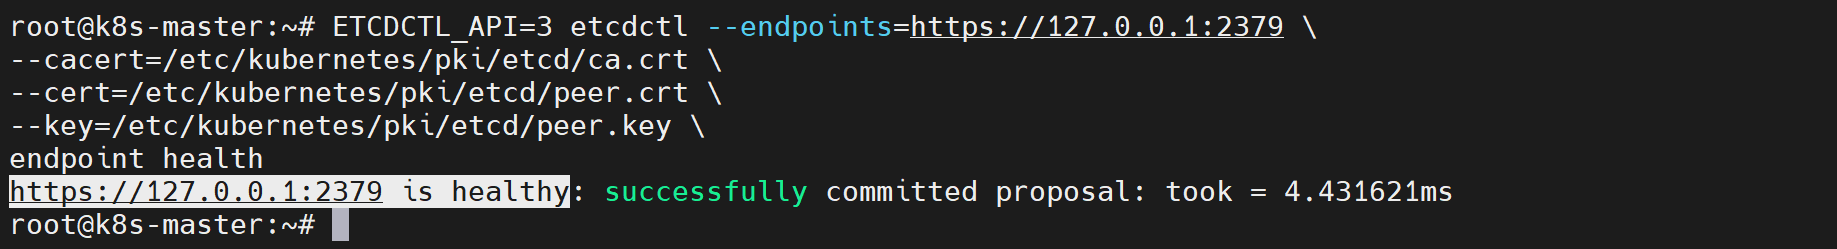
[Step2] 启动kubelet服务,查询ETCD数据库健康状态。
root@k8s-master:~# systemctl start kubelet.service
root@k8s-master:~# ETCDCTL_API=3 etcdctl --endpoints=https://127.0.0.1:2379 \
--cacert=/etc/kubernetes/pki/etcd/ca.crt \
--cert=/etc/kubernetes/pki/etcd/peer.crt \
--key=/etc/kubernetes/pki/etcd/peer.key \
endpoint healthETCDCTL_API=3:指定使用etcd API v3,监控检查仅支持API3。
etcdctl:ETCD官方命令客户端工具,用于和ETCD服务交互。
--endpoints=https://127.0.0.1:2379:指定连接的etcd服务地址。
--cacert=/etc/kubernetes/pki/etcd/ca.crt:CA根证书文件,校验etcd服务端证书合法性
--cert=/etc/kubernetes/pki/etcd/peer.crt:客户端证书,peer.crt为etcd节点之间相互通信使用
--key=/etc/kubernetes/pki/etcd/peer.key:客户端证书对应的私钥,与cert配套使用
endpoint health:检查etcd端点健康状态